





很多团队选 AI 算力,习惯先对着参数表比大小。但参数回答的是这台机器有多强,而不是适不适合你。判断一台算力设备值不值得选,要先弄懂背后的需求逻辑:你要跑的模型,到底需要多少显存、什么精度、多大的互联。
一、 先讲清楚:选算力,真正要看的其实是三件事
跑模型,决定算力需求的其实是三件事。
显存,决定能装下多大的模型。模型权重按参数规模占用空间,精度越低占用越小;显存除了装权重,还要留给 KV Cache 和并发,显存越大,能跑更大的模型、撑更高的并发、放更长的上下文。
算力精度,决定推理吞吐。同样一颗芯片,FP16、FP8、FP4 精度下的算力差异很大,低精度往往换来成倍的高吞吐,正是大规模推理需要的。
互联带宽,决定多卡多机协同。当模型大到单机放不下,卡与卡、机与机之间的互联速度,直接决定分布式推理能不能跑得顺。
这三件事组合起来,才构成一台机器适不适合你的真正依据。先看这三件事,再看参数,才不会被一张张规格表带偏。
二、 再从需求出发:你要跑什么规模的模型
弄懂原理,再对照自己的需求,判断就清楚多了。
如果业务跑的是百亿参数级别的模型,比如 Qwen 72B、Llama 3 70B 这一档,对算力的要求其实并不苛刻。以 FP16 为例,70B 模型权重约需 140GB 显存,配置充裕的机器能轻松容纳,多出的显存都用于支撑高并发和长上下文。此时选算力,重点看并发能力和响应延迟,而不是一味求大,把预算花在用不上的算力上反而是浪费。
如果业务规划部署千亿参数级别的开源大模型,比如 DeepSeek V3 这类 671B 的 MoE 模型、Llama 3.1 405B,情况就完全不同。671B 权重在 FP8 精度下约占 671GB,FP4 精度下约需 335GB。这种规模对显存、精度算力和互联的要求都高出一个量级,普通配置很难跑顺。
如果目标再往上,是万亿参数级别的超大模型,单机已经放不下完整权重,必须靠多机协同,这时互联能力就成了决定性因素,算力也早已不是单台设备的事,而是一整套集群方案。三种需求,三种选择逻辑,这就是从需求出发的意义。
三、 再看数聚红芯G9680 PR 这款产品怎么样
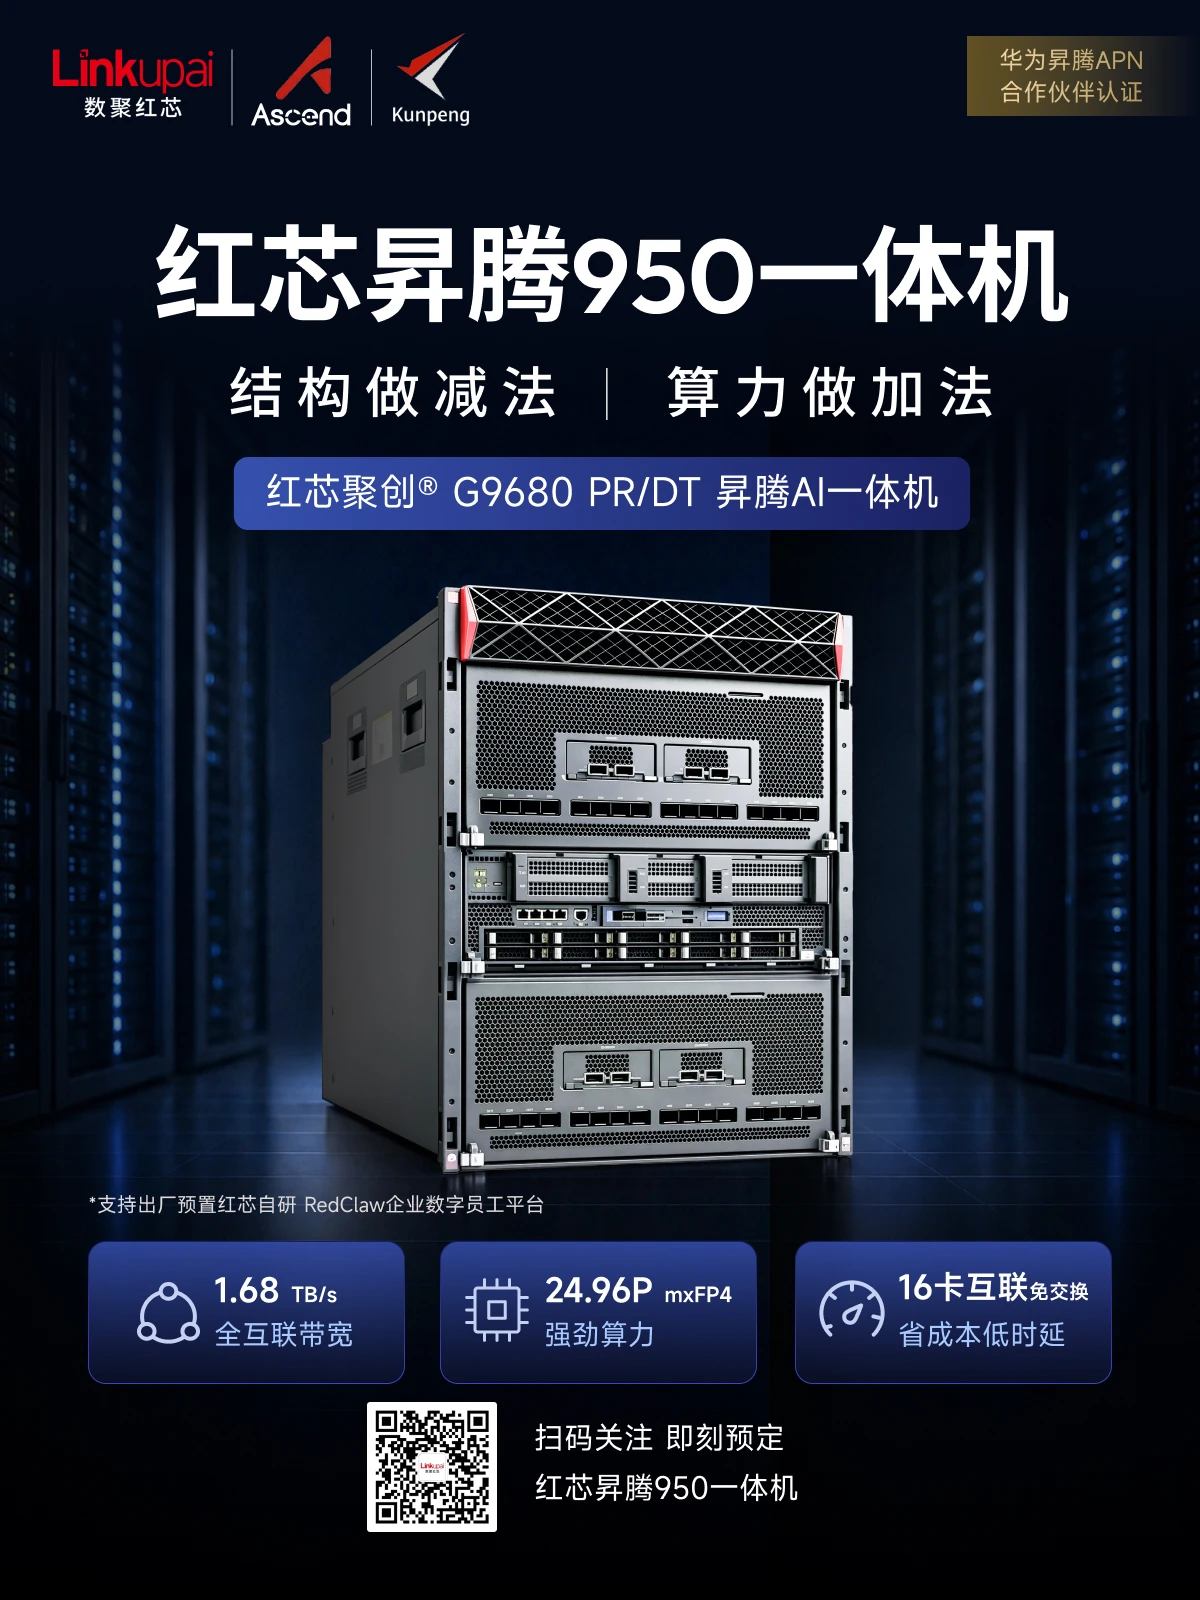
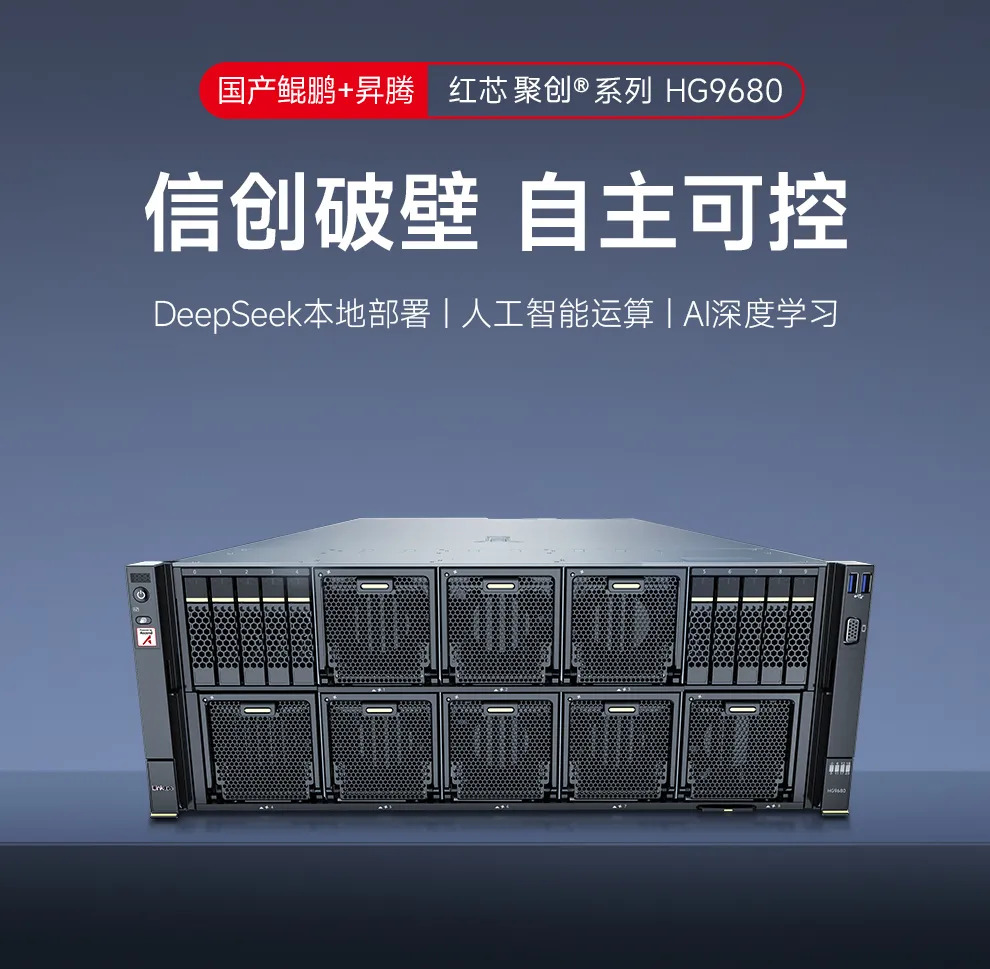
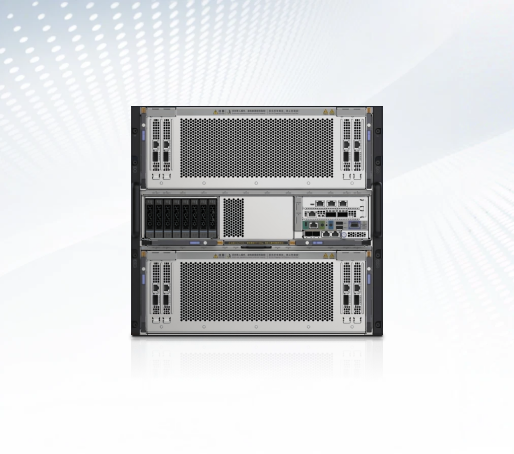
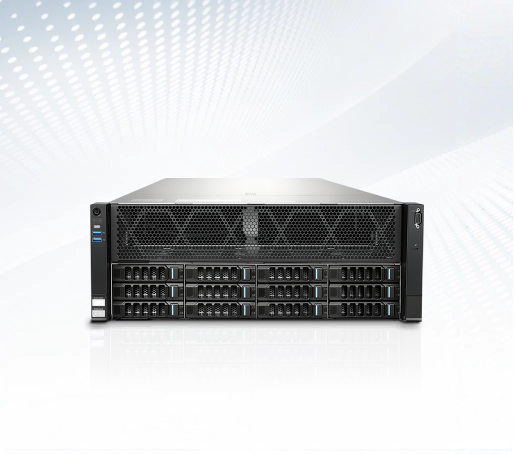
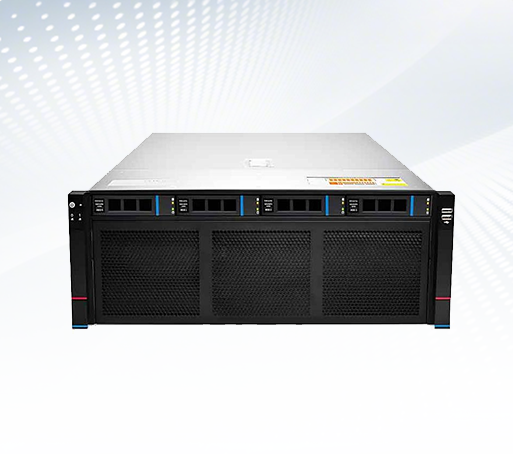
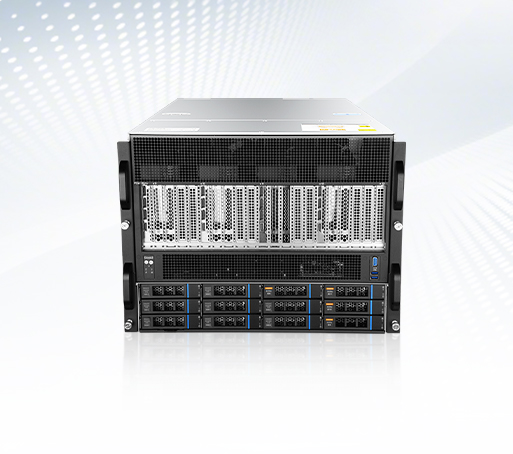
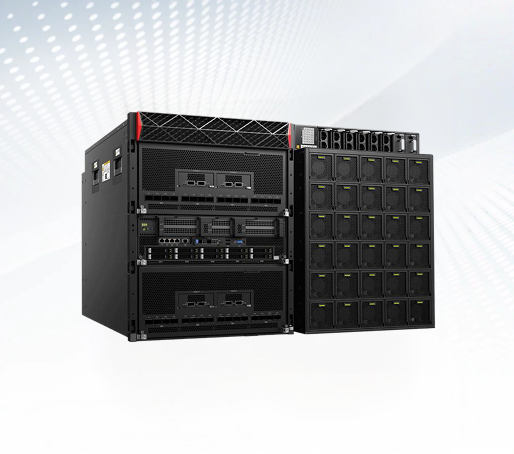
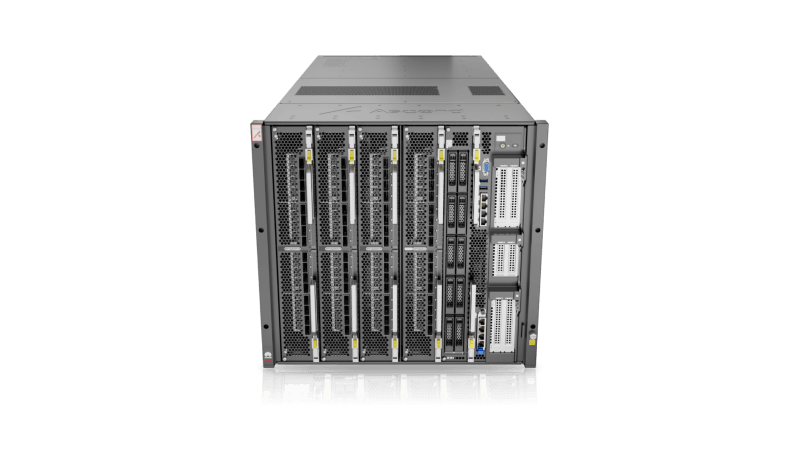
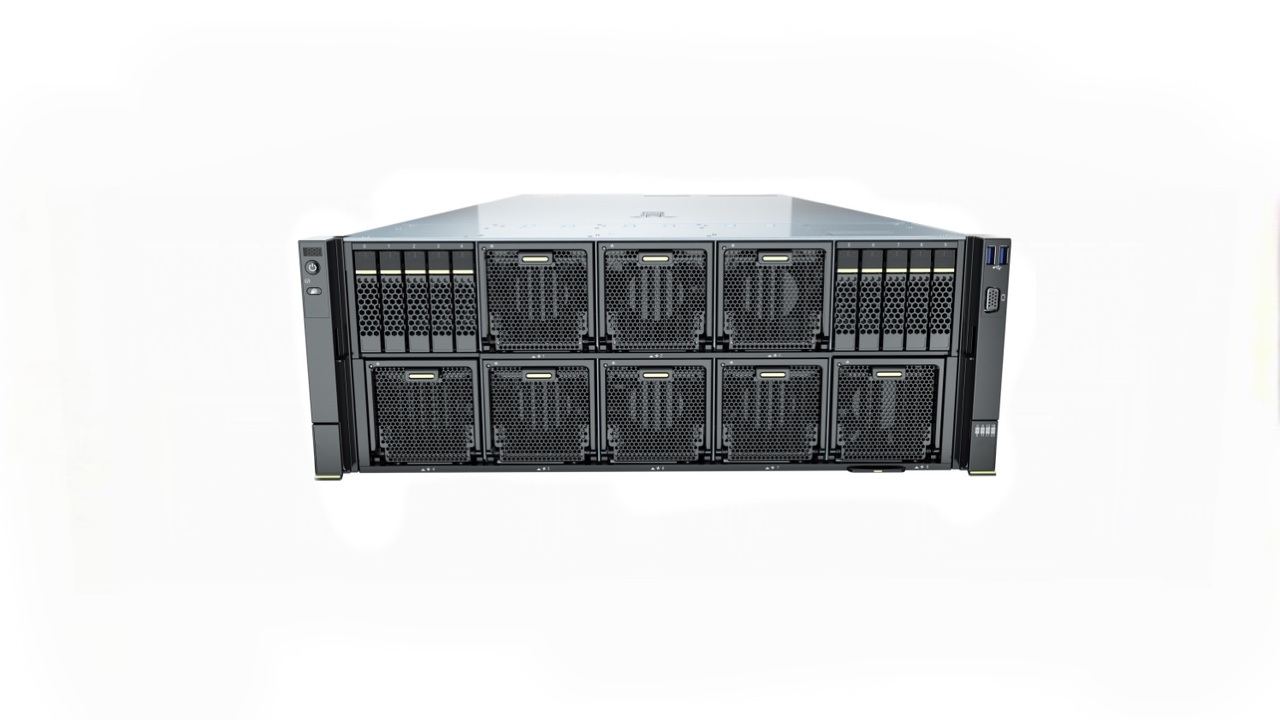
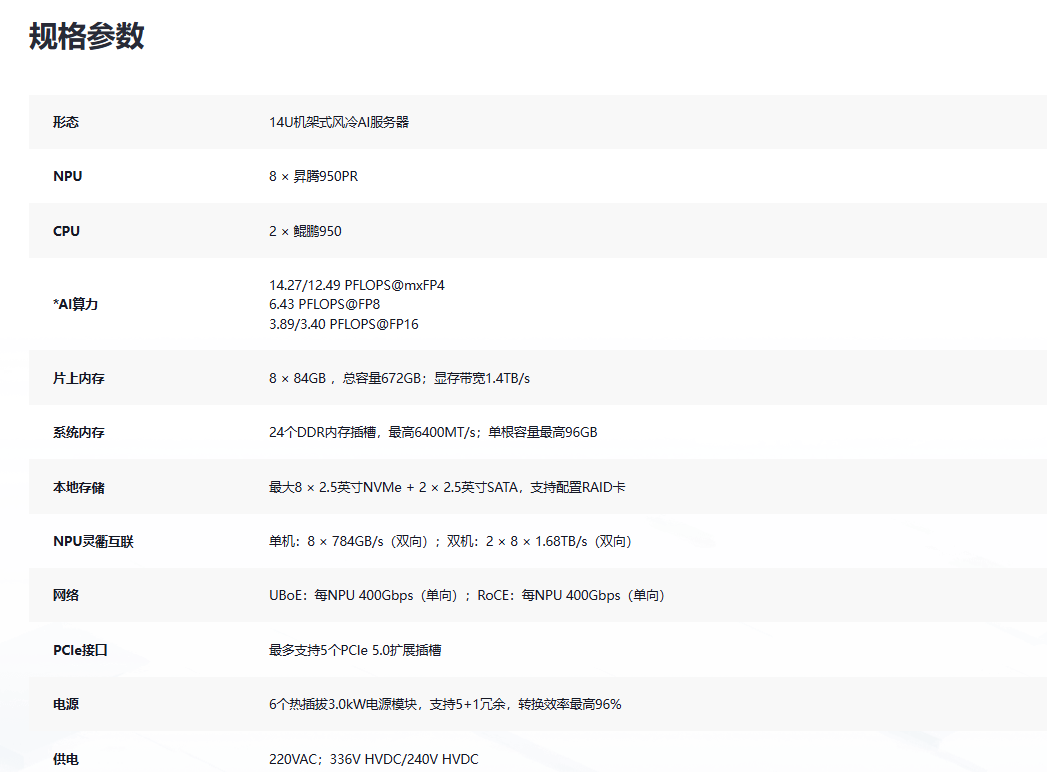
回到产品本身。G9680 PR 是数聚红芯推出的一台 14U 高密度风冷 AI 服务器,搭载 8 颗昇腾 950PR NPU 和 2 颗鲲鹏 950 处理器,设计目标很明确:面向高性能推荐、大模型 Prefill 和多模态推理,尤其是千亿级大模型的推理负载。把前面的需求逻辑套进来,它的匹配度就看得清清楚楚。
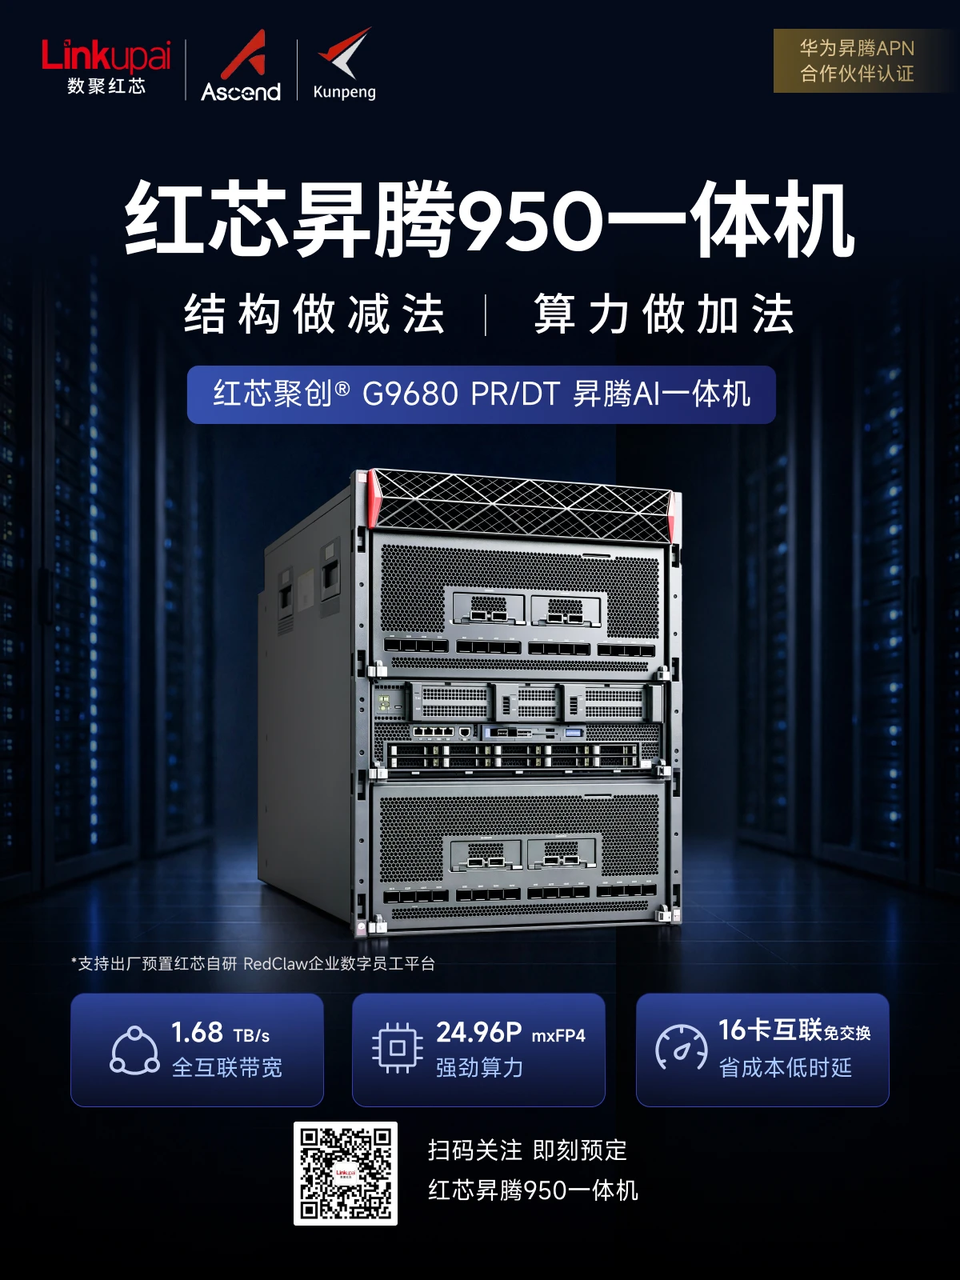
核心参数:
系统内存:24 个 DDR5 插槽,最高 6400MT/s,单根最大 96GB。
本地存储:最大 8 块 2.5 英寸 NVMe 加 2 块 SATA,可配置 RAID 卡。
扩展:最多 5 个 PCIe 5.0 插槽。
电源:6 个热插拔 3.0kW 模块,5 加 1 冗余,最大输入功耗约 14.5kW。
尺寸与环境:约 618.8 毫米高、447 毫米宽、920 毫米深,支持 5 到 35 摄氏度机房运行。
算力匹配:不同模型规模下的适配度
再看它与不同需求的匹配度,同样一目了然。
对千亿模型,这是它的主场。整机 672GB 片上内存,单颗 84GB、带宽 1.4TB/s,配合 6.43 PFLOPS 的 FP8 算力和 14.27 PFLOPS 的 mxFP4 算力,正是为 671B 级别的 MoE 大模型高吞吐推理准备的,这也是它和普通推理服务器最不一样的地方。
对百亿模型,它属于性能溢出,但价值在高并发和低延迟。FP16 下 3.89 PFLOPS 的算力能把单次推理延迟压得很低,单机就能扛起成百上千用户的并发请求,适合追求体验的高端场景。
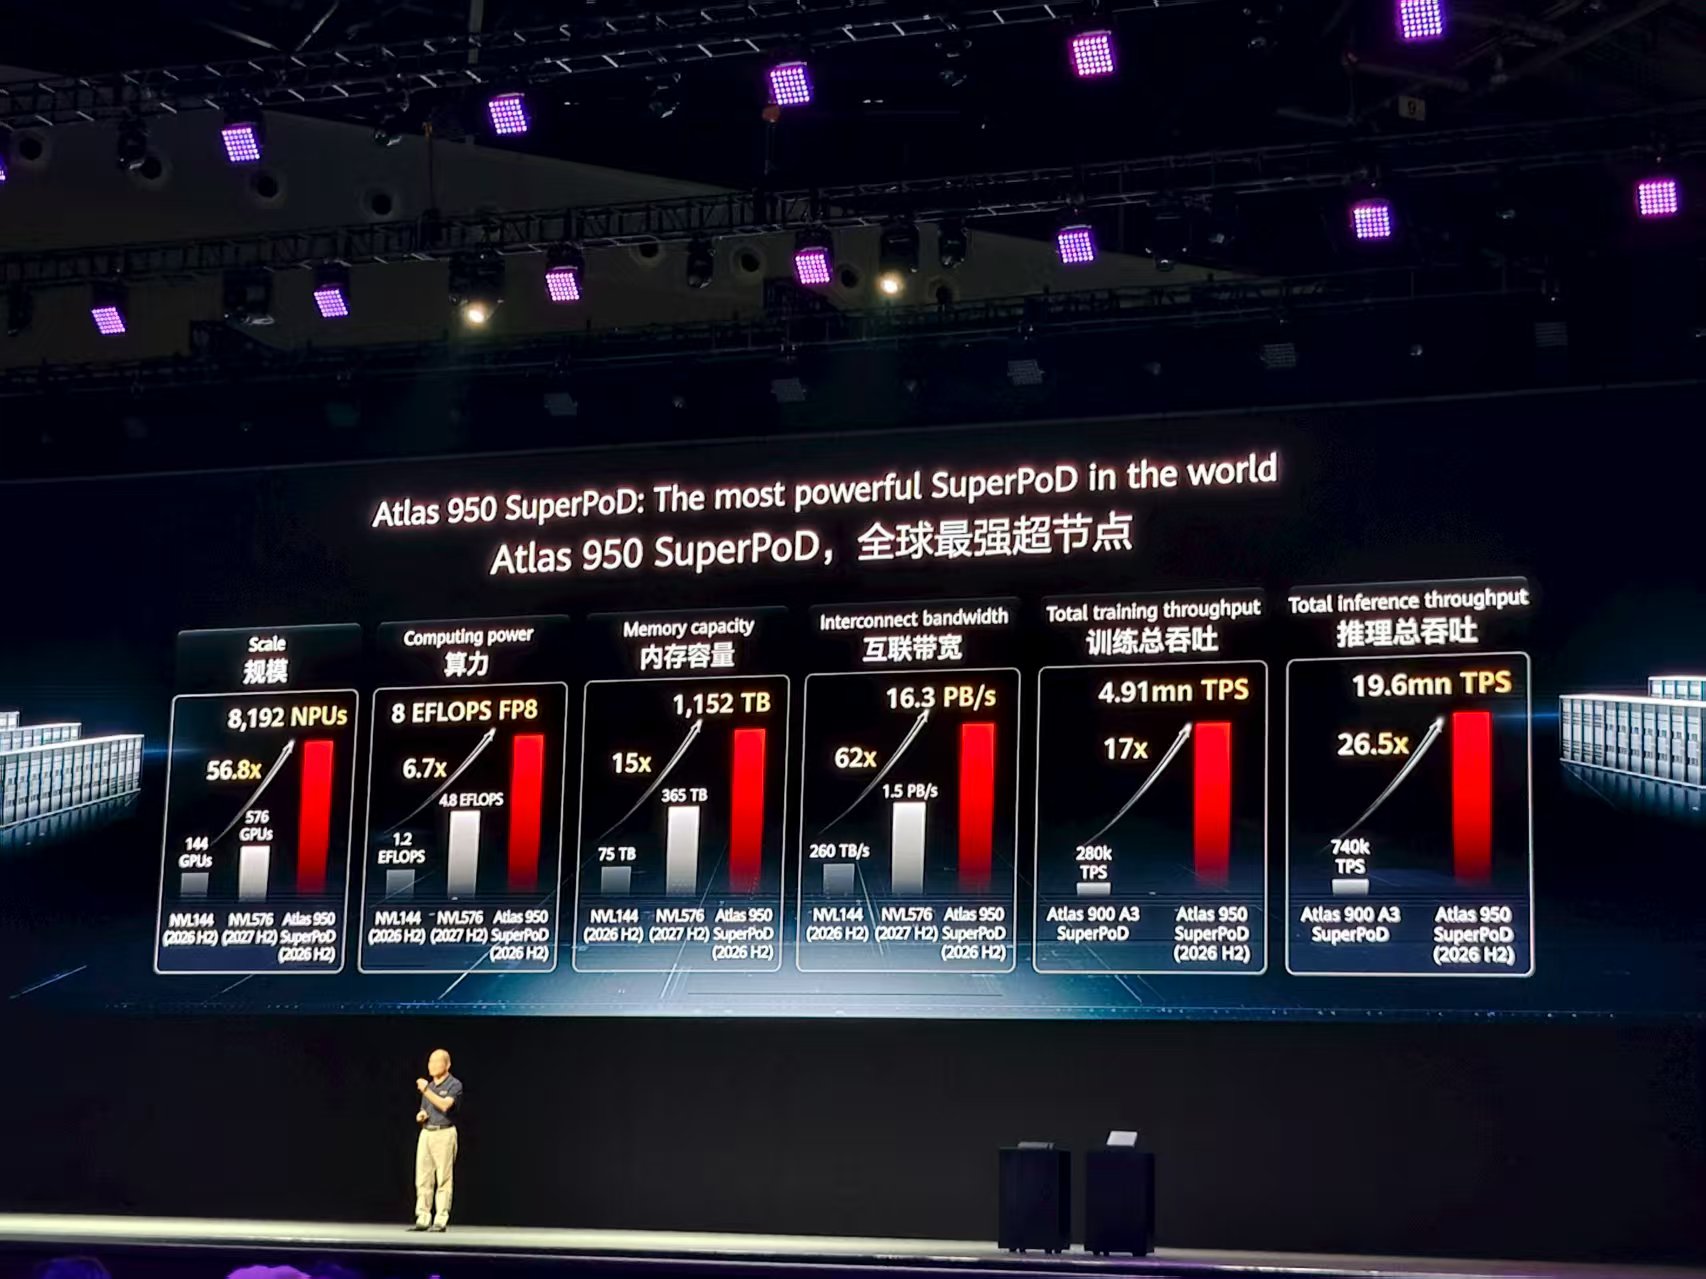
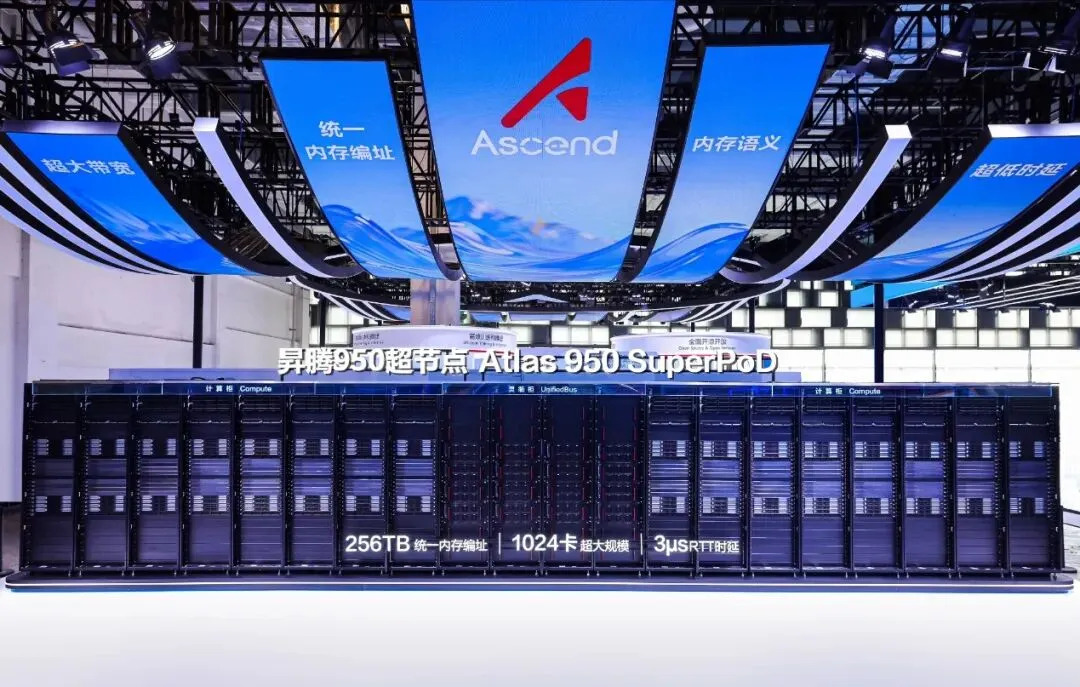
对万亿模型,它留足了扩展空间。单机 8 颗 NPU 通过 Full Mesh 高速互联,理论双向带宽约 6.27TB/s;支持双机 16 颗 NPU 高速互联,级联后可组成约 1.3TB 的显存池,配合每颗 NPU 400Gbps 的 RoCE 与 UBoE 网卡,为分布式推理铺好了路。
此外,这台机器的落地性也值得一提。它支持 HiF8、mxFP8、mxFP4 多种精度格式,团队能按模型和场景灵活选择吞吐与精度的平衡点;14U 高密度风冷架构可直接部署在通用机房,不依赖液冷改造;最高 96% 的电源转换效率和 5 加 1 冗余供电,让整机更稳定易部署;出厂还可预置红芯 LinkInfra 算力调度平台,把算力资源的调度与管理一并收拢。
四、 说到底,还是匹配需求
回到需求视角,结论很清楚:如果只跑百亿级模型,预算有限时可以考虑降级配置,不必为用不上的算力买单;如果业务明确要跑千亿级 MoE 大模型,G9680 PR 这类一体机是当前昇腾生态里值得考虑的旗舰选择;如果规划更长远、要上万亿模型,它的双机互联能力也给了向上扩展的空间。
算力采购从来不是越贵越好,而是匹配需求。先弄懂原理、看清需求,再看产品,才不会在参数表里迷失方向。
如果你正在评估千亿级大模型推理的算力方案,或想了解 G9680 PR 在不同场景下的详细配置,欢迎通过以下方式与我们取得联系。
官网:https://www.linkupai.cn
产品咨询:可通过数聚红芯官网产品中心在线咨询,或联系专属销售顾问,获取一对一的选型与部署建议。