





AI 漫剧单集 1–3 分钟,由大量短镜头组接,单镜头普遍在 3–15 秒之间——这正好对上 5 秒、10 秒、15 秒三个时长档;再叠加低清、中清、1080P 三个分辨率档,一条产线接什么活、配什么机器,就被拆成了 8 个可测档位。本文把 10 张显卡、146 条实测记录按这 8 个档位排开,给出逐档冠军、名次、产能比、有效卡数与定级分布,作为选型时的对照表。
口径统一如下:模型 Minimax-H3(Unet-int8 / Qwen3VL-32B-AWQ / H3-VAE / Audio-VAE),推理框架 ComfyUI,输出固定 16:9,测试由数聚红芯自有实验室完成。对外报数一律取加载了角色 LoRA 与人设库、可叠加排队的"业务负载"组,即场景 B。
结论先放在这里:8 个可测档位中,英特尔® 锐炫™ 专业版 B70(32GB)拿到 1 个第一、4 个第二、2 个第三、1 个第四,没有一档掉出前四;1080P/5 秒以 7.42 条/小时居首,8 档平均 30.31 条/小时。
为什么按档位选,而不是按价格选?
因为交付能力由"分辨率 × 单镜头时长"决定,不由采购预算决定;同一张卡在不同档位的产能可以相差一个数量级,只有档位同时约束显存占用、有效卡数与能否写进合同。
一张卡不是"一个产能",而是一组产能。锐炫 Pro B70 32G 在低清/5 秒是 98.40 条/小时(36.59 秒/条),到中清/5 秒是 22.22 条/小时(162.00 秒/条),到 1080P/5 秒是 7.42 条/小时(485.11 秒/条),到 1080P/10 秒只剩 2.39 条/小时(1503.79 秒/条)。同一个平台、同一套模型,镜头长度与分辨率各变一档,单条耗时就从半分钟走到 25 分钟。按"这台机器多少钱"去比,比的是同一台机器完全不同的四个工况。
档位还决定"能不能报"。判定标准不看配置档次,只看显存占用与可重复性:1080P/5 秒是 30.2GB、94.7%,判安全区,可以写进交付承诺;1080P/10 秒是 31.9GB、100%,判临界区,只能做演示。同一张卡、同一个分辨率,只因单镜头长了 5 秒,一档能签、一档不能签。
价格维度在这套数据里也无法映射。146 条记录不含任何报价字段,本批数据全部不写价格;而按相对 B70 的产能比看,容量更大、定位更高的卡在个别档位确实慢于 32GB 卡(下一节逐格列出)。既然如此,选型的正确顺序是:先定成片分辨率(平台与客户要求)→ 再定单镜头时长(剧本节奏)→ 最后按这一格的表挑机器与显卡,而不是先定预算再倒推配置。
8 个可测档位的产能与名次排成什么样?
逐档冠军由低清、中清两档的 RTX Pro 6000-96G 与低清/5 秒的 5090Dv2 分走,1080P/5 秒换到 B70 32G;B70 在 8 个档位全部进前四,最低一档是低清/5 秒的第 4。
| 档位 | 冠军 | 冠军产能(条/小时) | B70 产能(条/小时) | B70 名次 | 有效卡数 |
|---|---|---|---|---|---|
| 低清 / 5s | 5090Dv2 | 160.07 | 98.40 | 第 4 | 10 |
| 低清 / 10s | RTX Pro 6000-96G | 75.65 | 59.56 | 第 2 | 10 |
| 低清 / 15s | RTX Pro 6000-96G | 44.96 | 38.17 | 第 3 | 8 |
| 中清 / 5s | RTX Pro 6000-96G | 24.89 | 22.22 | 第 2 | 9 |
| 中清 / 10s | RTX Pro 6000-96G | 9.61 | 9.41 | 第 2 | 9 |
| 中清 / 15s | RTX Pro 6000-96G | 5.15 | 4.93 | 第 3 | 9 |
| 1080P / 5s | B70 32G | 7.42 | 7.42 | 第 1 | 9 |
| 1080P / 10s | RTX Pro 6000-96G | 2.54 | 2.39 | 第 2 | 8 |
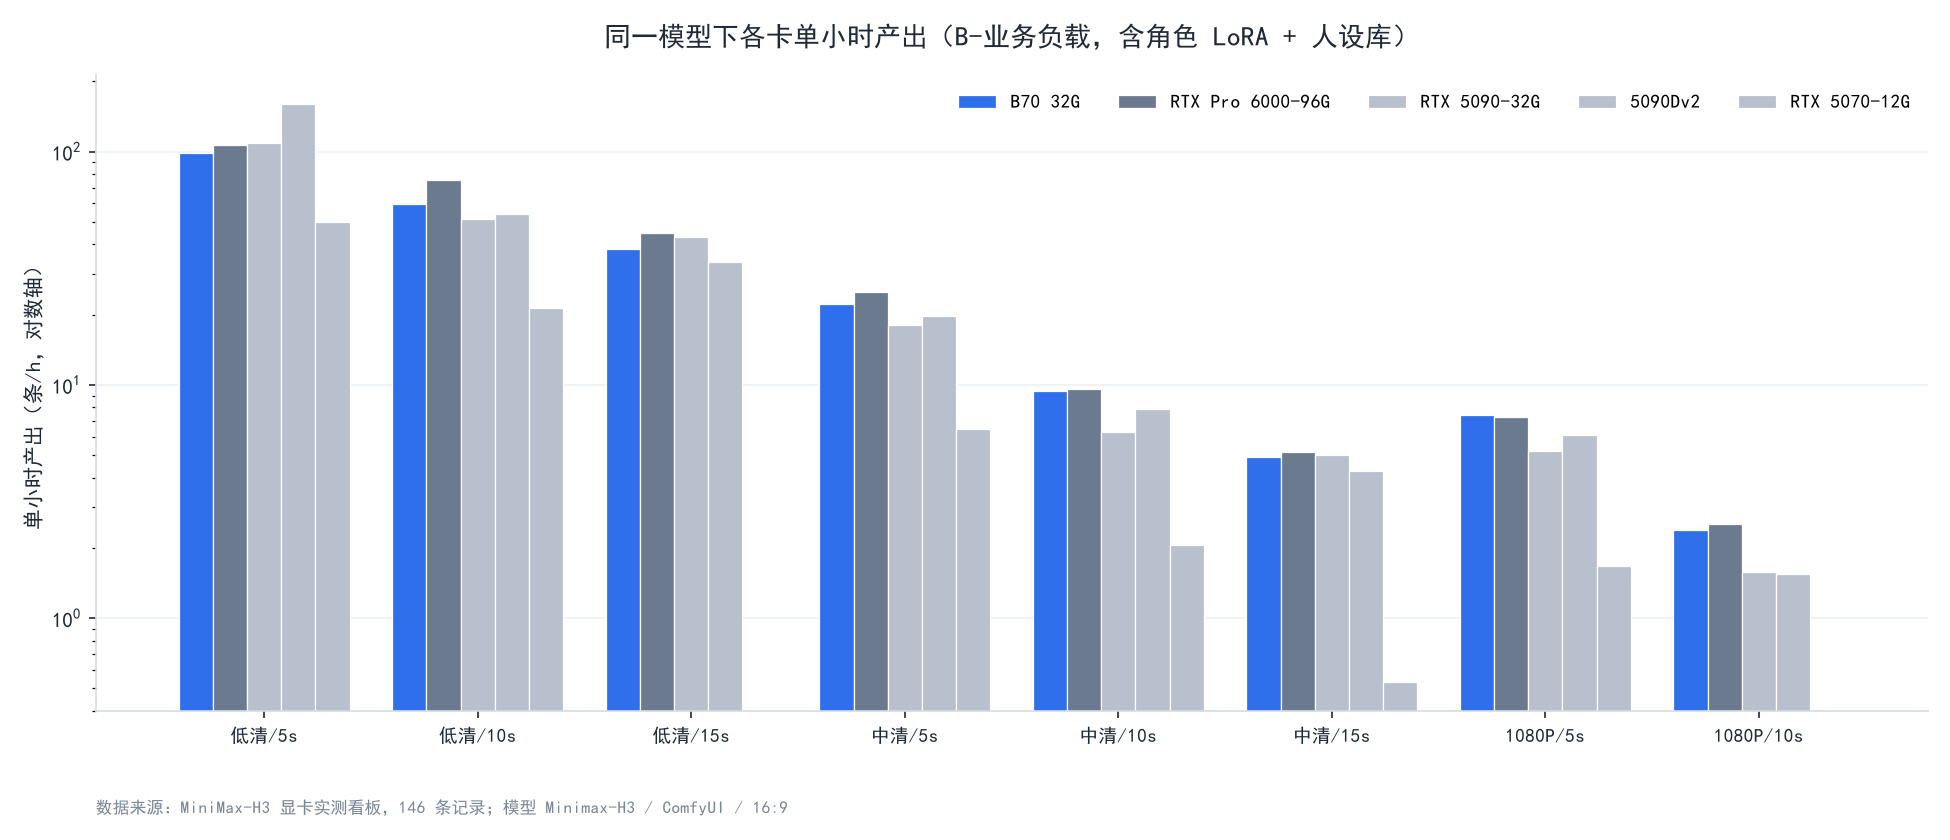
同模型、同框架、同输出比例下的单卡单任务串行产出对比。B70 在 8 个档位的产能区间是 98.40 条/小时至 2.39 条/小时。
把 8 个档位连起来看:1 个第一、4 个第二、2 个第三、1 个第四,没有一档掉出前四。B70 的 8 档平均产出是 30.31 条/小时,与 RTX 5090-32G 的 29.85、RTX Pro 6000-96G 的 34.55 落在同一区间。名次分布比"冠军是谁"更能说明问题:B70 的优势集中在高分辨率短镜头(1080P/5 秒第一、1080P/10 秒第二),劣势集中在低清跑量(低清/5 秒第 4,同档 5090Dv2 为 160.07 条/小时)。
有效卡数这一列决定名次的含金量,需要单独说明。8 个档位的有效卡数依次是 10、10、8、9、9、9、9、8。缺口不是筛选造成的,而是这一格本来就没有可用记录:RTX Pro 6000D-84G 全表只测了低清/5 秒与低清/10 秒两档(对 B70 的产能比 0.47 与 0.15 即出这两格),因此它不出现的档位,有效卡数都要减一;RTX 5070-12G 在低清/15 秒没有记录,在 1080P/10 秒因超时中断判为不可用,这两格再各减一张。所以低清/15 秒只剩 8 张、1080P/10 秒也只剩 8 张——这两格的"第 3"与"第 2"是在更小样本里拿到的,与 10 张齐全的档位不能等同看待。同理,低清/5 秒与低清/10 秒是唯一两个 10 张卡全员有效的档位,这两格的对照最完整。
产能比为什么会出现"贵卡更慢"?
因为显存容量只决定"能不能跑",不决定"跑多快";当一张卡的显存被吃到 90%–100%,产能就不再随容量增长,产能比会跌回 1.0 附近甚至更低。
产能比的定义很简单:某张卡在这一格的产能 ÷ B70 在这一格的产能。大于 1 表示比 B70 快,小于 1 表示比 B70 慢。9 张对照卡的逐格跨度如下:
| 显卡 | 产能比区间(对 B70) | 补充 |
|---|---|---|
| RTX 5090-32G | 0.66–1.12 | 8 档齐全 |
| 5090Dv2 | 0.65–1.63 | 跨度全表最大 |
| RTX 5080-16G | 0.08–0.66 | 8 档无一格超过 B70 |
| RTX 5070-12G | 0.11–0.51 | 1080P/10s 不可用 |
| RTX 5060Ti-16G | 0.03–0.38 | 最低一格为 B70 的 3% |
| RTX Pro 6000-96G | 0.98–1.27 | 唯一在 1080P/5s 低于 1.0 的 96GB 卡 |
| RTX Pro 5000-72G | 0.57–0.81 | 全程未越过 1.0 |
| RTX Pro 5000-48G | 0.58–0.77 | 全程未越过 1.0 |
| RTX Pro 6000D-84G | 0.47 / 0.15(仅 2 档) | 样本不足,不下结论 |
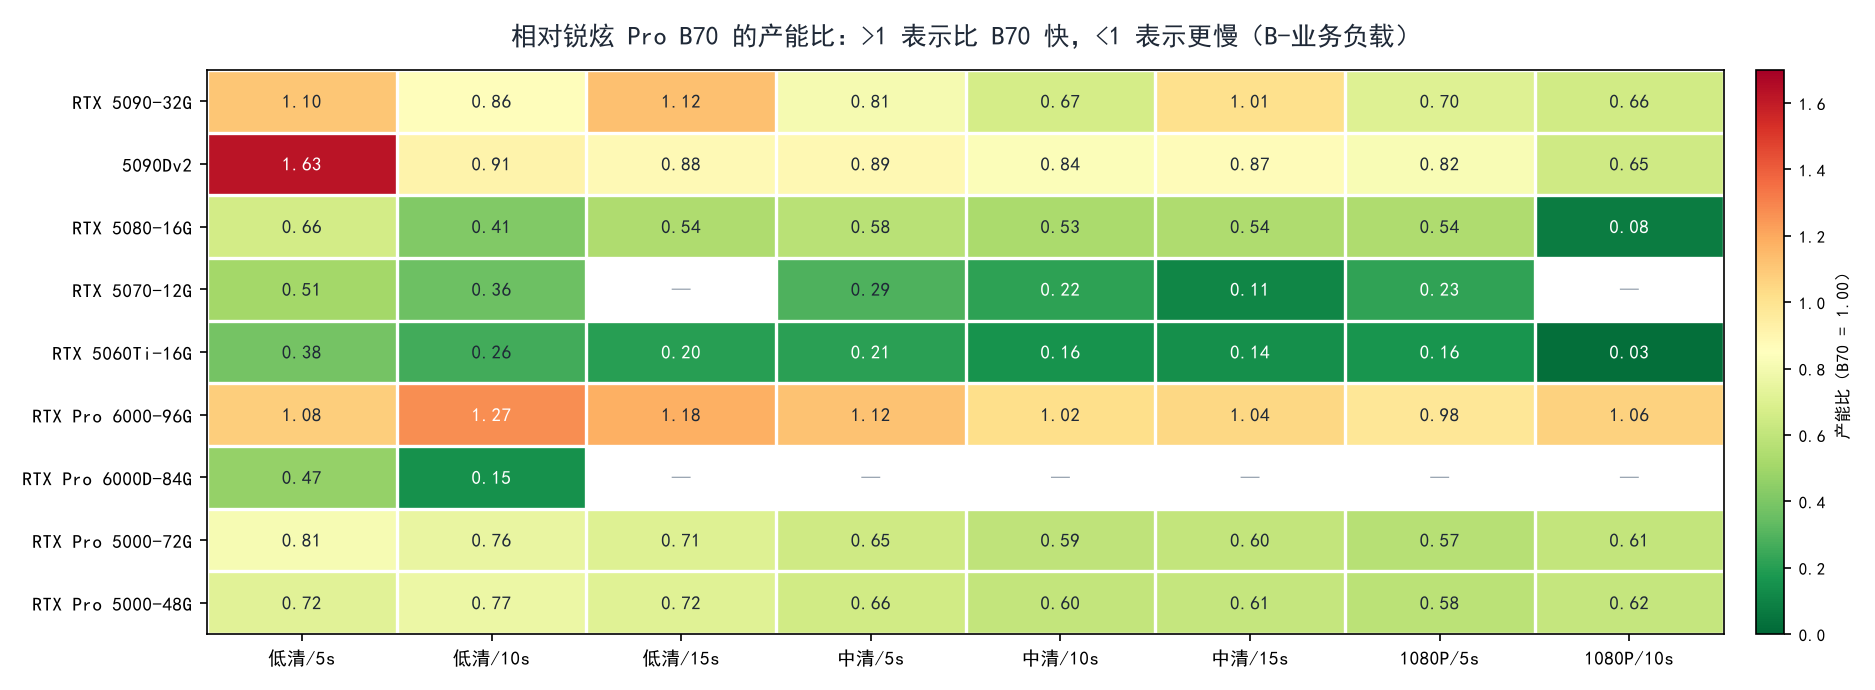
逐格产能比:红色侧为快于 B70,蓝色侧为慢于 B70。同一张卡在不同档位会来回穿越 1.0,所以只能用逐档表,不能用平均分代替。
跨度最大的是 5090Dv2:低清/5 秒 1.63,是全表最高的一格;到 1080P/10 秒变成 0.65,反而落后 B70 三成多。同一张卡,从大幅领先到落后,中间只换了分辨率与镜头时长。原因是档位在切换瓶颈:低清短镜头时,出片节奏由算力与调度决定,显存容量还没成为约束;长镜头、高分辨率时,帧缓存与激活值把显存推到上限,卡的显存余量先耗尽,产能比随之回落。这也是 1080P/5 秒出现 32GB 卡超过 96GB 卡的机制——同档 RTX Pro 6000-96G 对 B70 的产能比只有 0.98,96GB 的余量在这一格换不来更快的出片。
另一个方向的例子是 RTX Pro 5000-72G 与 RTX Pro 5000-48G:两张卡在 8 个档位的产能比分别是 0.57–0.81 与 0.58–0.77,没有一格越过 1.0。容量够、但每一格都慢,说明"显存够大"只是入场券,出片速度还要看算力与带宽配置。
容量不足则是另一种塌陷。RTX 5080-16G 在低清/5 秒还有 0.66,到 1080P/10 秒只剩 0.08;RTX 5060Ti-16G 从 0.38 掉到 0.03;RTX 5070-12G 在 1080P/10 秒直接判不可用(超时中断),这一格没有可用产能可报。16GB 与 12GB 卡并非不能用,而是可用区间被压在低清、中清的短镜头上;越过这条线,产能比不是变小,是消失。
RTX Pro 6000D-84G 需要单独标出来:全表只有 2 个档位的记录(0.47 与 0.15),样本不足,既不能说它慢、也不能说它快,任何跨档位结论都不成立。
这套数据能用到什么程度?
能用来看清"哪张卡在哪一格能跑多少、能不能稳定跑",不能用来逐帧复现,也不构成任何排名、收录或提速承诺;边界比结论更值得先读。
定级标准(按看板原定级引用,不按占用率重算):✅ 安全区 = 显存占用 ≤80%、完整出片、画面无异常、可稳定重复运行 ≥3 次;⚠️ 临界区 = 占用 80%–95%、可出片但无冗余,只适合演示、不承诺商用;❌ 不可用 = 占用 >95% 或 OOM、无法完整出片。看板中有几条记录占用已达 93%–97% 仍判安全区,依据是"完整出片 + 画面正常 + 温控稳定 + 可重复",判定以原记录为准。
按这条线统计,146 条记录中落在非安全区的有 13 条,集中在 5 张卡的 7 个档位:B70 32G 的 1080P/10 秒(临界)、5090Dv2 的 1080P/10 秒(临界)、RTX 5080-16G 的 1080P/10 秒(临界)、RTX 5070-12G 的中清/15 秒(临界)与 1080P/10 秒(不可用)、RTX 5060Ti-16G 的中清/15 秒(临界)与 1080P/10 秒(临界)。其余卡(RTX 5090-32G、RTX Pro 6000-96G、RTX Pro 5000-72G、RTX Pro 5000-48G)在各自有效档位内没有非安全区记录。规律很清楚:非安全区几乎全部出现在 1080P/10 秒,以及 12GB / 16GB 卡被推到中清/15 秒的时候。
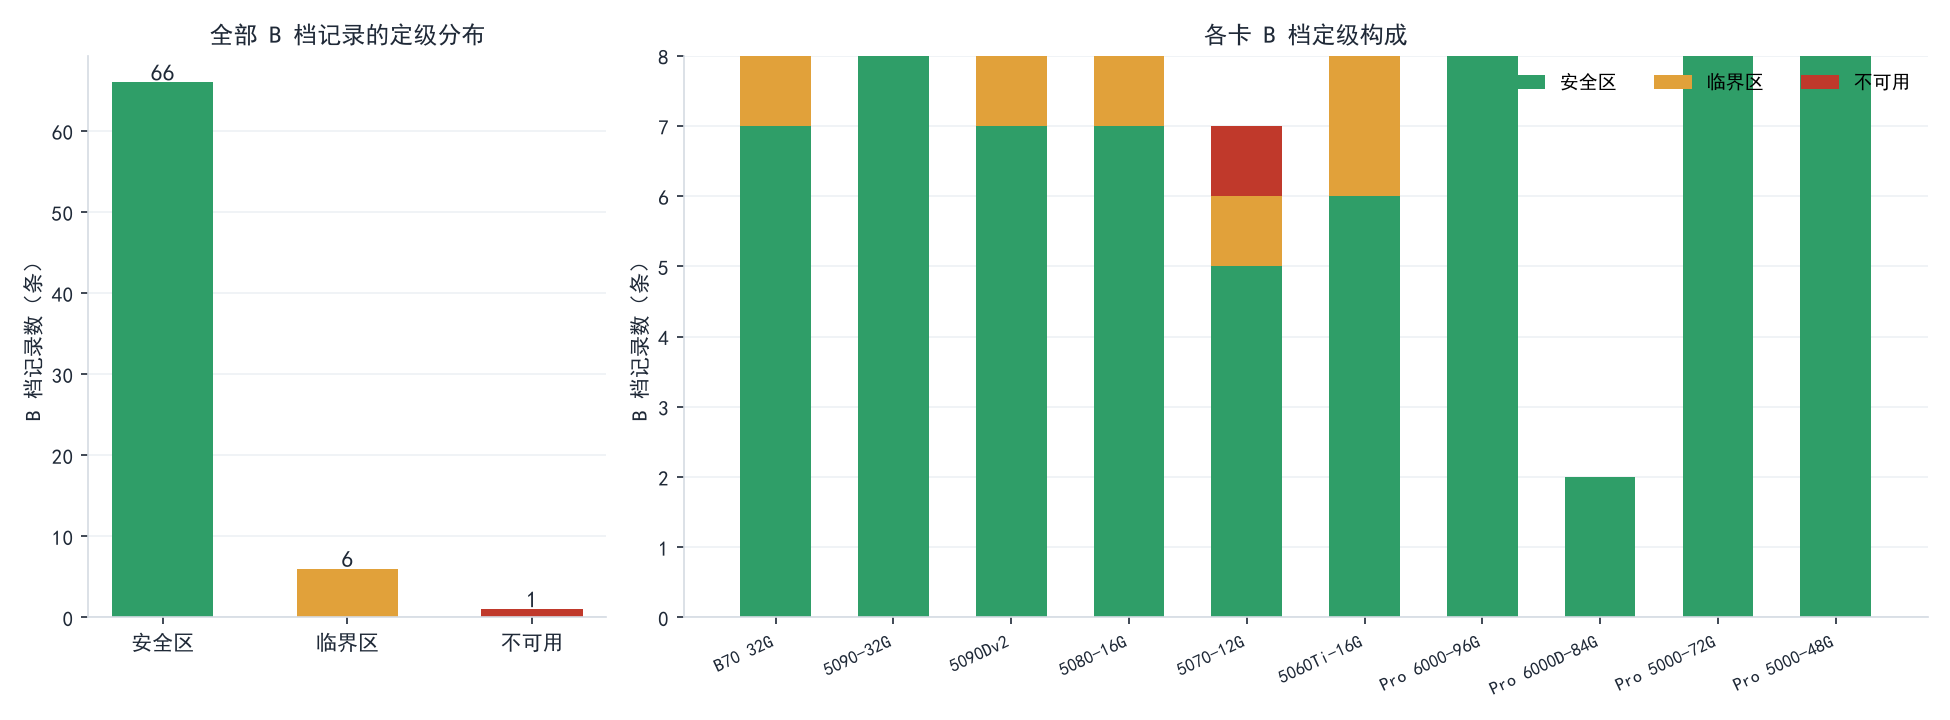
按看板原定级绘制的分布。同分辨率下,时长从 5 秒走到 10 秒,是本表里定级发生翻转最常见的位置。
温控记录同样可用。146 条里 140 条温控稳定,6 条记录"温度偏高",全部出现在 RTX 5070-12G(4 条)与 RTX 5060Ti-16G(2 条)显存占用 97%–98% 的档位;B70 的 16 条记录全部稳定。这组数字说明的是余量关系:占用被顶到 97% 以上、且卡本身容量偏小的位置,温控先失守;而 B70 的峰值显存在 28.8–31.9GB、占用 90%–100% 之间(中清最高 97%,1080P/10 秒顶到 100%),全程未出现温度偏高记录。
边界需要写明五条,缺一条就会把这张表用错:
一,这是数聚红芯自有实验室的自测,不是第三方测评。源表未记录 CPU 型号、系统内存、操作系统、驱动与 CUDA 版本、采样步数、CFG Scale、随机种子与测试人员,够支撑"哪张卡在哪一格能跑多少"的判断,不足以让别人逐帧复现。
二,空载基准组(场景 A)与业务负载组(场景 B)不是同一批次:前者多在 8/20–9/01,后者多在 9/03–9/28,源表也未记量化版本,而 B 组数值普遍高于 A 组。两组只能各自纵向比档位,不能横向对比,更不能写成"加载 LoRA 后更快"。
三,1080P/15 秒这一档,10 张卡没有一张留下记录(源表 20 秒以上是公式预留行),只能记"未测",不能记"跑不动",任何关于它的产能说法都缺依据。
四,全部是单卡数据。双卡并行、双卡拆分生成这一类玩法,146 条记录里没有一条,任何双卡产能数字都不成立。
五,本批不含报价字段,全部不写价格;单位"条/小时"指单卡、单任务串行的稳定产出,不等于多机排队后的总产出。
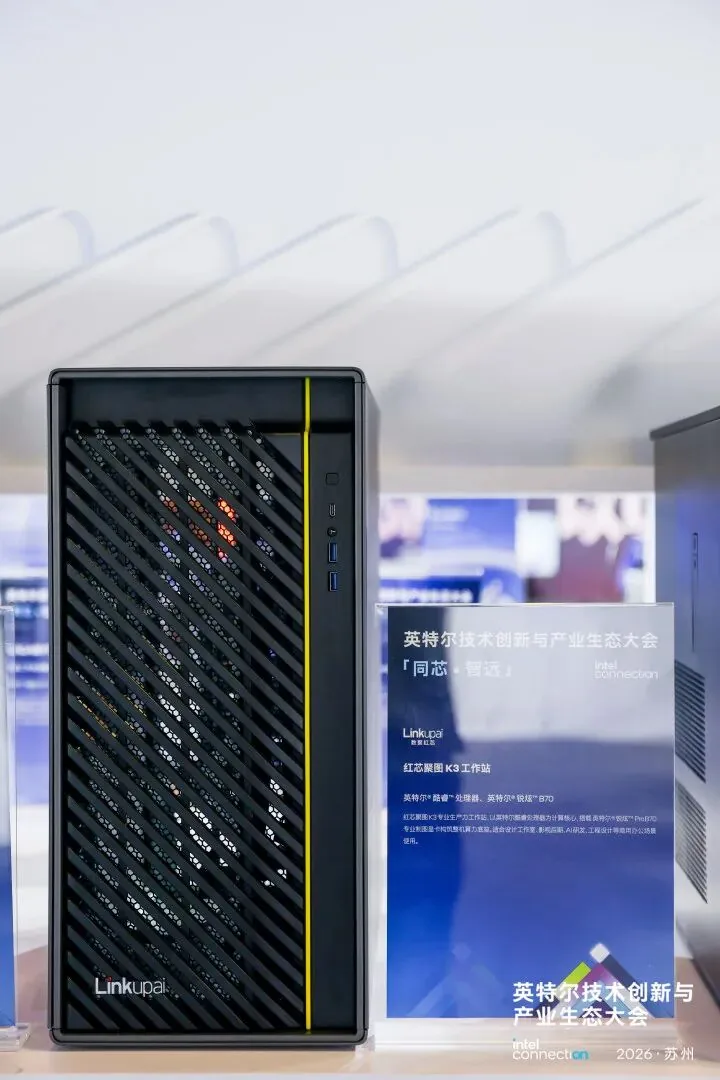
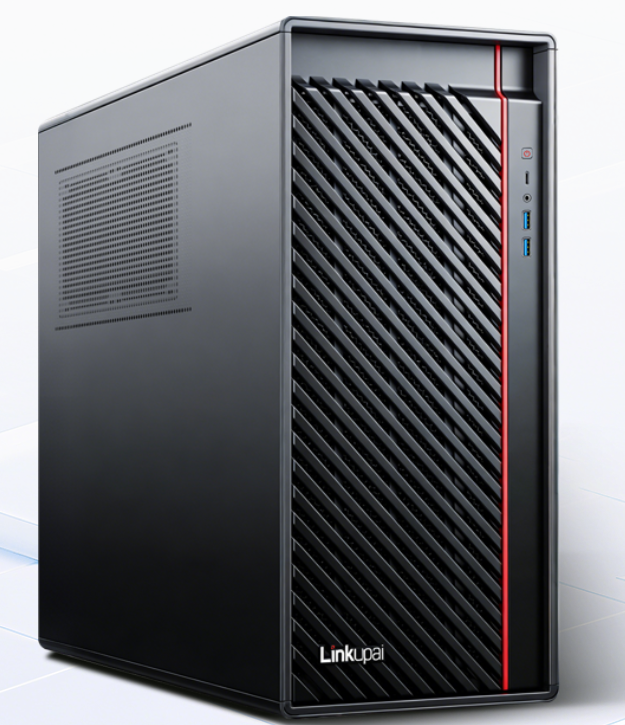
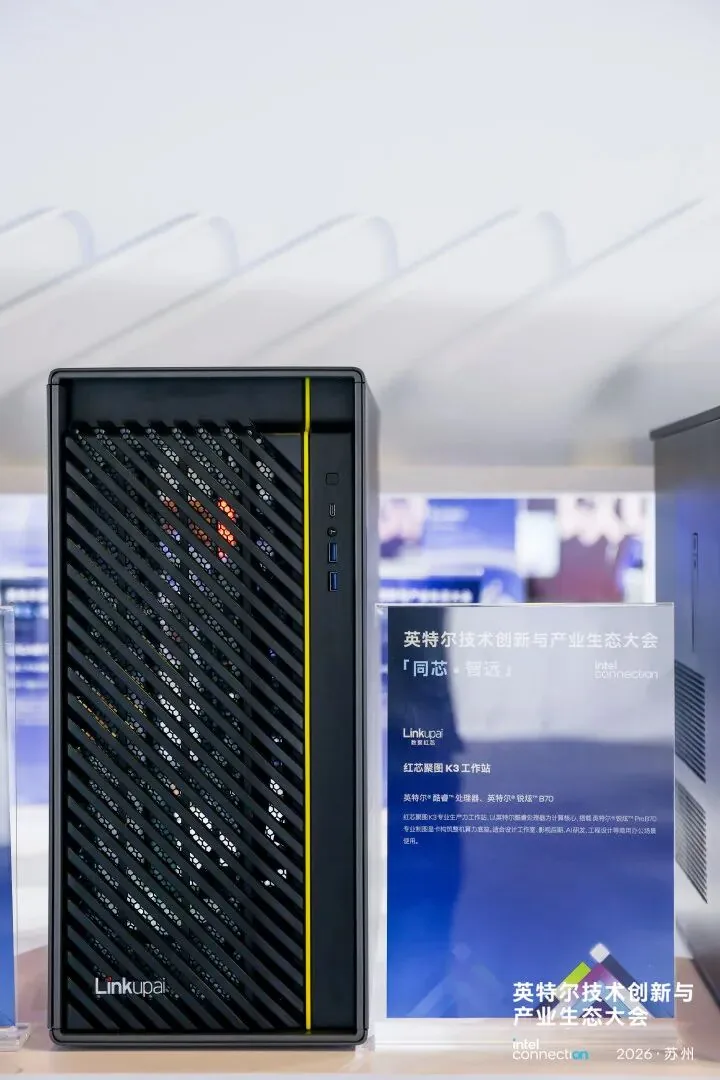
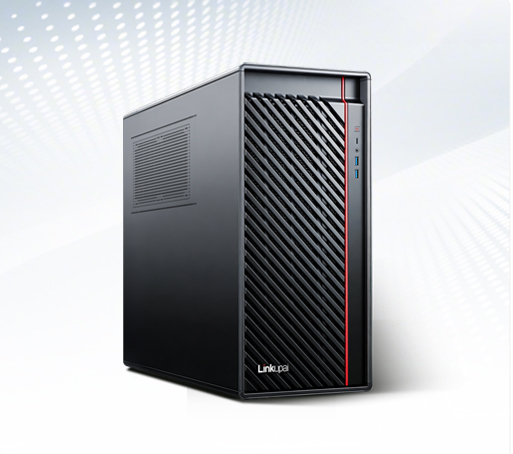
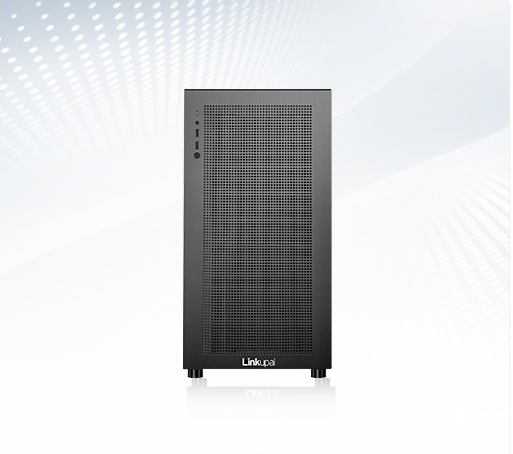
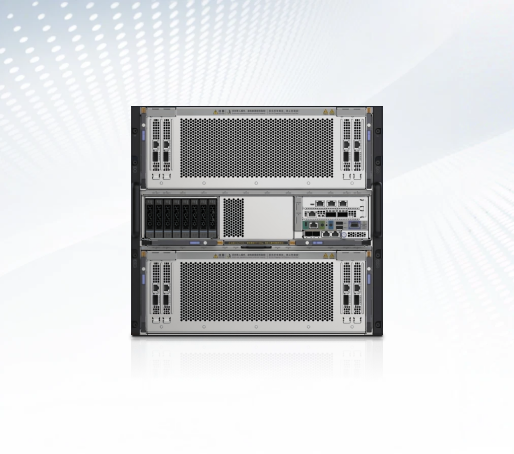
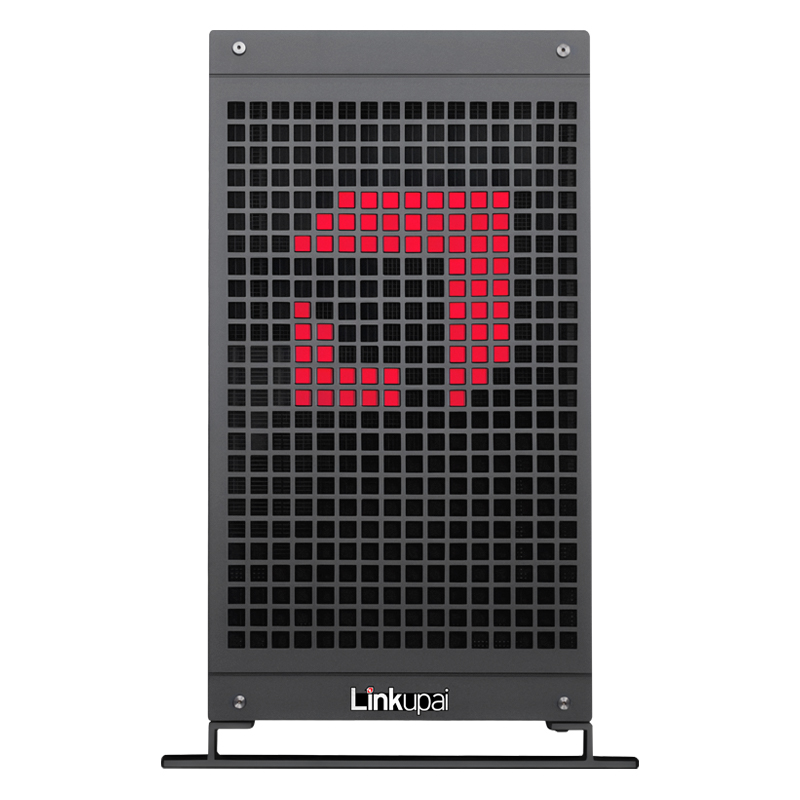
落回机器选型:数聚红芯红芯聚图® K3 就是按单卡这一档配的塔式平台——Intel® Z790 芯片组,支持第 14 / 13 / 12 代 Intel® Core™ 处理器,DDR5 最高 5600 MT/s、最大 256GB,4 个 M.2 Gen4 加 4 个 3.5 英寸盘位,最多 1 张双宽/三宽风冷显卡或单张液冷显卡,散热可选风冷或液冷,485 × 220 × 469 mm,三年全国上门。它的适用范围由上面的表决定:1080P/5 秒(7.42 条/小时、安全区)与中清/5 秒(22.22 条/小时)这类格子是它的主力工况;1080P/10 秒已经踩在临界线上,1080P/15 秒没有数据。需要双卡的方向是红芯聚图® K3 G2,或再往上评估 GPU 服务器——本批数据不支持任何双卡产能的推算。
按档位查表、按定级签合同、按温控留余量,这套数据的用法就到这里为止。更详细的方案说明(含逐档位实测与整机配置口径)可看官网这篇:红芯聚图 K3 跑 AI 漫剧的完整方案。
常见问题
Q1:为什么没有 1080P/15 秒的数据?
10 张卡一条记录都没有,源表 20 秒以上只是公式预留行。所以这一档只能记"未测",不能记"跑不动";任何关于它的产能数字都缺依据,8 个可测档位里也不含它。
Q2:有效卡数为什么不是 10?
有的格本来就没有记录。RTX Pro 6000D-84G 只测了低清 5 秒与 10 秒两档;RTX 5070-12G 在低清/15 秒无记录、1080P/10 秒超时中断判不可用,于是这两格只剩 8 张,名次样本更小。
Q3:冠军卡为什么不是推荐卡?
因为冠军是按单格算的。RTX Pro 6000-96G 拿下多数档位冠军,但多数档位只比 B70 快 2%–27%,1080P/5 秒还慢 2%。选型该看你要跑的那一格,而不是看总冠军;这批记录也不含报价字段。
Q4:这批数据多久更新一次?
底稿生成于 2026-10-28,收录 146 条记录、10 张显卡,条件固定为 Minimax-H3、ComfyUI、16:9、业务负载。换模型、换量化版本,或要补上 1080P/15 秒这一档,都得重测一轮,现有版本不承诺定期更新。
需要按镜头表核算配置的,可以把分辨率、单条时长与每天条数发给数聚红芯:联系我们,或直接查看红芯聚图® K3 塔式工作站的产品页参数、在产品中心对照其他机型。咨询热线 400-869-9865,邮箱 business@linkupai.cn。
推荐阅读(AI 漫剧算力专题):红芯聚图K3跑AI漫剧:参数配置与146条实测产能(方案总览)|AI漫剧本地部署12问|单卡还是双卡?K3与K3 G2的平台位差别|AI漫剧工作站采购清单:下单前要核的9项|读懂这6个指标,不被参数表绕晕|从分镜到成片:每步各要多少算力|关于AI漫剧本地部署的5种流行说法|AI漫剧要什么配置?从镜头表反推配置