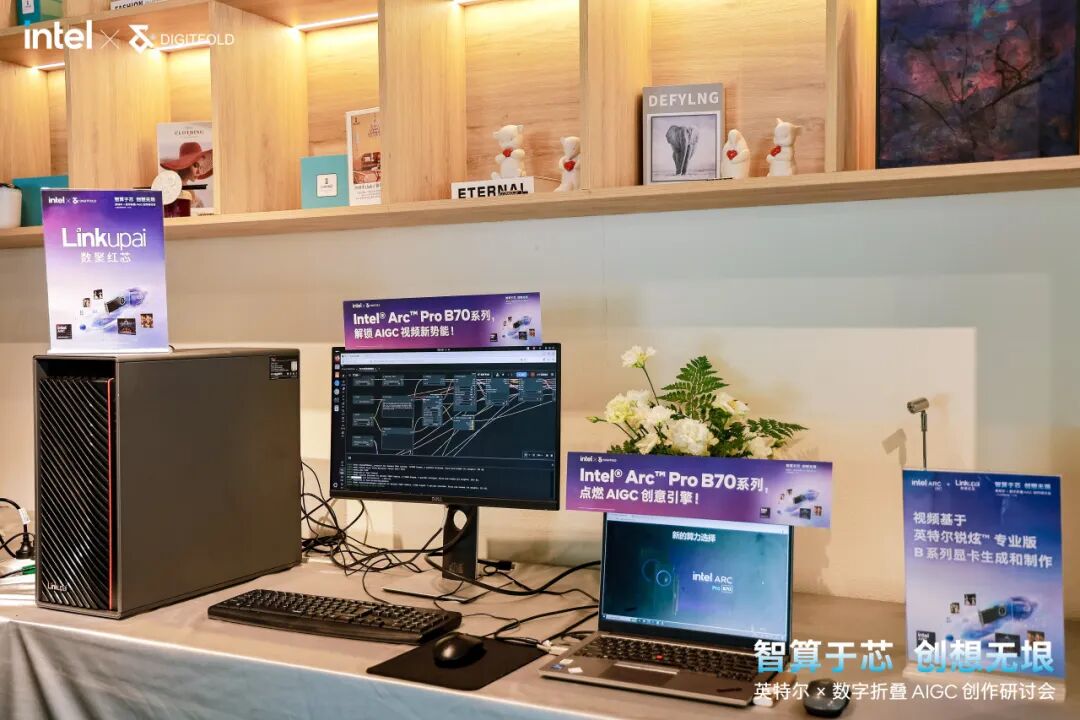






AI 漫剧本地部署这件事,讨论的人多,能拿出来对账的数据少。数聚红芯在自有实验室用 MiniMax-H3 跑了一轮显卡对照:146 条记录、10 张显卡,条件固定为 ComfyUI 推理、16:9 输出、低清/中清/1080P 三档分辨率 × 5s/10s/15s 三档时长。数据摆在那里,有些流传很广的说法就不太站得住,也有些说法方向对、边界没说清。
下面挑 5 种最常见的说法,一条一条用这批实测回答。每条都分三层:说法原文怎么讲、实测数据怎么显示、我们据此认为应该怎么理解。所有数字都注明分辨率、时长与场景(A 空载基准 / B 业务负载),不写没测过的档位。
显存越大越好,还是小卡也够用?
不一定。96GB 的卡在多数档位只比 32GB 的 B70 快 2%~27%,1080P/5s 还慢 2%;12GB 的卡到中清以上就掉进临界区和不可用。选卡要看档位产能,不是容量排序。
说法一:"显存越大越好,按容量排序买卡不会错"
实测怎么看:在 B 档(业务负载)的 8 个可测档位里,96GB 的 RTX Pro 6000-96G 相对 32GB 的 B70,产能比依次是 1.08 / 1.27 / 1.18 / 1.12 / 1.02 / 1.04 / 0.98 / 1.06——换算过来就是多数档位快 2%~27%,而 1080P/5s 那一档是 0.98,比 B70 慢 2%。另一张同为 32GB 的 RTX 5090-32G,8 个档位里有 5 个低于 1.00,最低 0.66。显存容量差了三倍,产能差的是几个百分点。
正确理解:容量不等于产量。在这套模型和这个框架下,32GB 已经装得下全部可测档位的中间态——MiniMax-H3 的量化 pruned int8 权重约 21GB,B70 各档位峰值显存 28.8–31.9GB、占用 90%–100%,全程完整出片。多出来的 64GB 并没有换成条/小时。所以选卡的正确顺序是:先按自己的镜头表圈出要跑的分辨率与单条时长,再看那张卡在那个档位的条/小时,最后才看容量和平台。
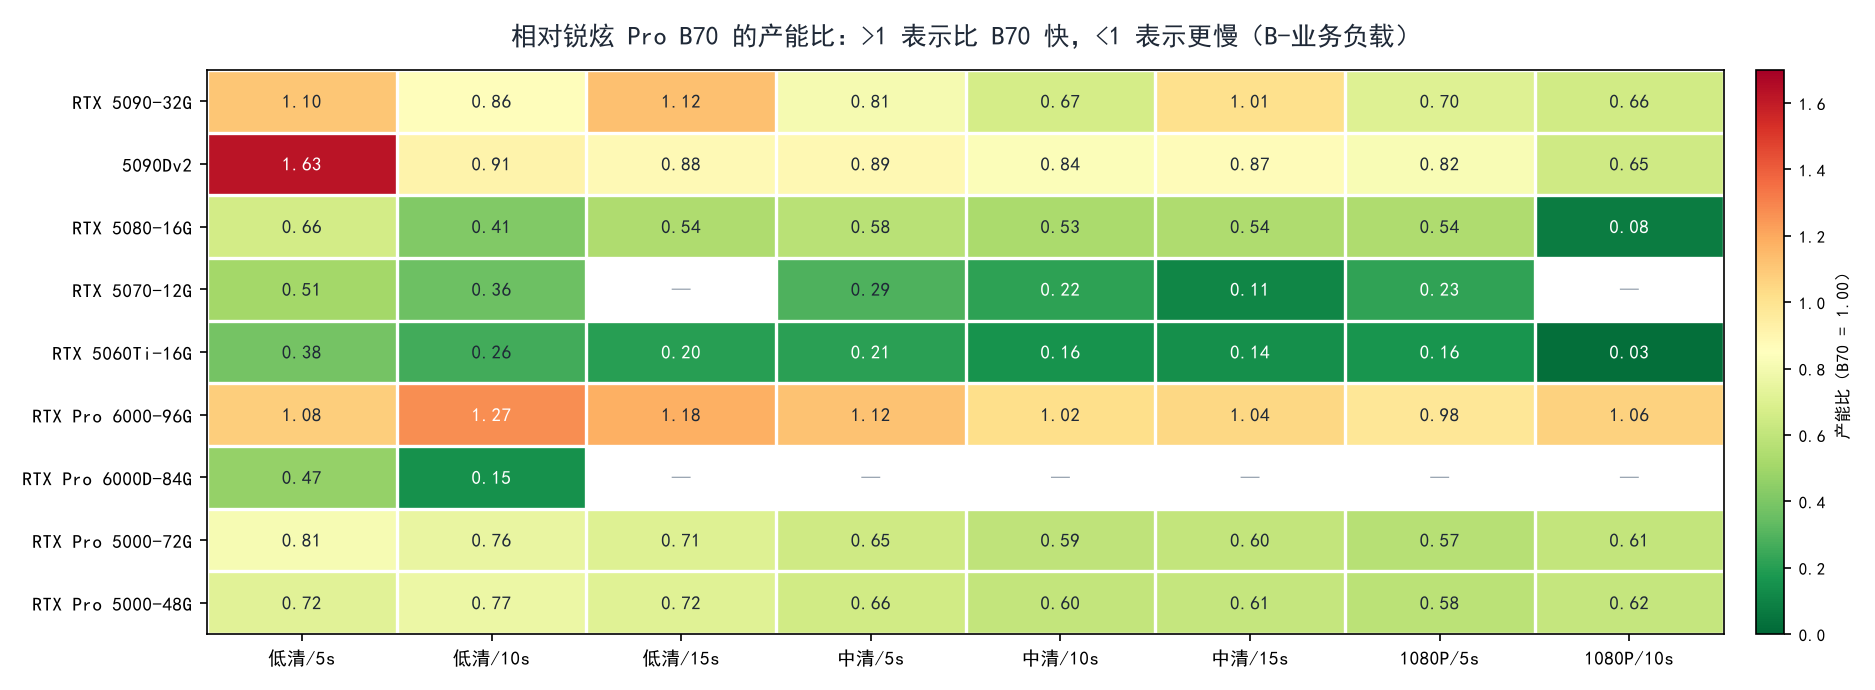
同模型、同框架、同输出比例下各卡相对 B70 32G 的产能比,1.00 为与 B70 持平。对比看的是档位,不是容量。
说法四:"12GB 的卡便宜,做短镜头也够"
实测怎么看:5070-12G 相对 B70 的产能比落在 0.11–0.51,最好的档位只有 B70 的一半左右,最差的只剩一成上下。更要紧的是定级:中清/15s 显存占用到 97%,判临界区——能出片,但没有冗余;1080P/10s 直接超时中断,判不可用。同代 16GB 的卡在高清档同样塌陷,5080-16G 的 1080P/10s 产能比是 0.08,5060Ti-16G 是 0.03。
正确理解:低清快切、出试稿、把流程跑通,小卡够用;接中清以上的订单,小卡不是"慢一点",是直接掉进临界区和不可用区。另外 146 条记录里 6 条温控偏高,全部出现在 12GB 与 16GB 卡占用 97%–98% 的档位——高占用除了慢,还多出一笔稳定性成本。B70 的 16 条记录温控全部稳定。
本地只能跑到 720P,数据是不是被业务负载压慢了?
两件事要分开看。1080P/5s 实测 7.42 条/小时,这一档在 9 张有效卡里排第 1;而 A(空载)与 B(业务负载)两组不是同一批次,说"业务负载压慢一半"没有数据基础。
说法二:"本地只能跑到 720P,做不了正经片子"
实测怎么看:B70 在 1080P/5s 档实测 7.42 条/小时(485.11 秒/条),1080P/10s 是 2.39 条/小时(1503.79 秒/条,判临界区)。放在 10 张卡的对照里,1080P/5s 这一档 B70 排第 1,1080P/10s 排第 2,不是"跑不动"的位置。
这个说法里有一半是真的:本地链路里 MiniMax-H3 只开源了 H3-Base,原生输出是 768P 级加原生立体声,2K 要靠超分或托管接口。"720P"这个数字接近原生输出的那一档。但"只能"不成立——1080P 这一档能跑,而且产能有数可查。
正确理解:1080P 是"档位",不是"承诺"。同一分辨率下,5s 是安全区(峰值显存 30.2GB、占用 94.7%),10s 是临界区(31.9GB、100%),15s 全表未测。订单里 1080P 长镜头占比高的团队有三条路:缩短单镜头时长(漫剧单镜头普遍 3–15 秒,本来就是这个节奏)、用超分或托管接口补高分辨率、或者换平台。三条都不是"不能做",是"要多算一道"。
说法三:"业务负载会把卡压慢一半"
实测怎么看:底稿里 A 组(空载基准,裸模型单任务串行,不加载 LoRA、人设库、风格插件)和 B 组(业务负载,加载角色 LoRA 与人设库,可叠加排队)不是同一批次——A 组多在 8/20–9/01 测,B 组多在 9/03–9/28 测,源表也没有记录量化版本与采样步数。两组数字放一起看,B 组普遍更高:B70 低清/5s 是 46.27 → 98.40,中清/5s 是 6.82 → 22.22,1080P/5s 是 1.85 → 7.42。
正确理解:这两组不能横向比较,方向也跟"压慢一半"相反——但同样不能读成"带负载更快"。能读的只有各自组内的纵向阶梯:同一组里,分辨率升一档、时长加一倍,产能怎么掉,是真实可信的。跨组做减法,减出来的是批次差(测期、量化版本、采样步数),不是负载差。对外报数统一用 B 档,因为它最接近漫剧工作室的真实生产状态;A 档只用来做流程侧参考。
买台机器就等于一劳永逸吗?
不是。146 条里 6 条温控偏高,B70 的 1080P/10s 只能判临界区,源表还缺 8 个关键字段。机器到货是产线的开始,不是终点。
说法五:"买台机器就一劳永逸"
实测怎么看:146 条记录里 140 条温控稳定、6 条偏高;B70 的 16 条全部稳定,但 1080P/10s 仍落在临界区——能出片,不能写进承诺。按看板原定级,B70 的 8 个业务负载档位里 7 个安全区、1 个临界区,没有一档是"所有分辨率、所有时长都稳"。而且源表缺 CPU 型号、系统内存、操作系统、驱动/CUDA 版本、采样步数、CFG Scale、随机种子与测试人员,换个环境重跑,数字会漂。
正确理解:机器是产线的一环,另外三环是调参、排队与兜底。调参要落到采样步数、CFG、量化版本这些源表都没记的项上;排队要算清业务负载叠加后的净产出,而不是空载峰值;监控要看占用率、温度与单条耗时的漂移;兜底要有超分或托管接口,接住 1080P 长镜头这类临界档位。把这四件事一起算进方案,机器才成为产线。
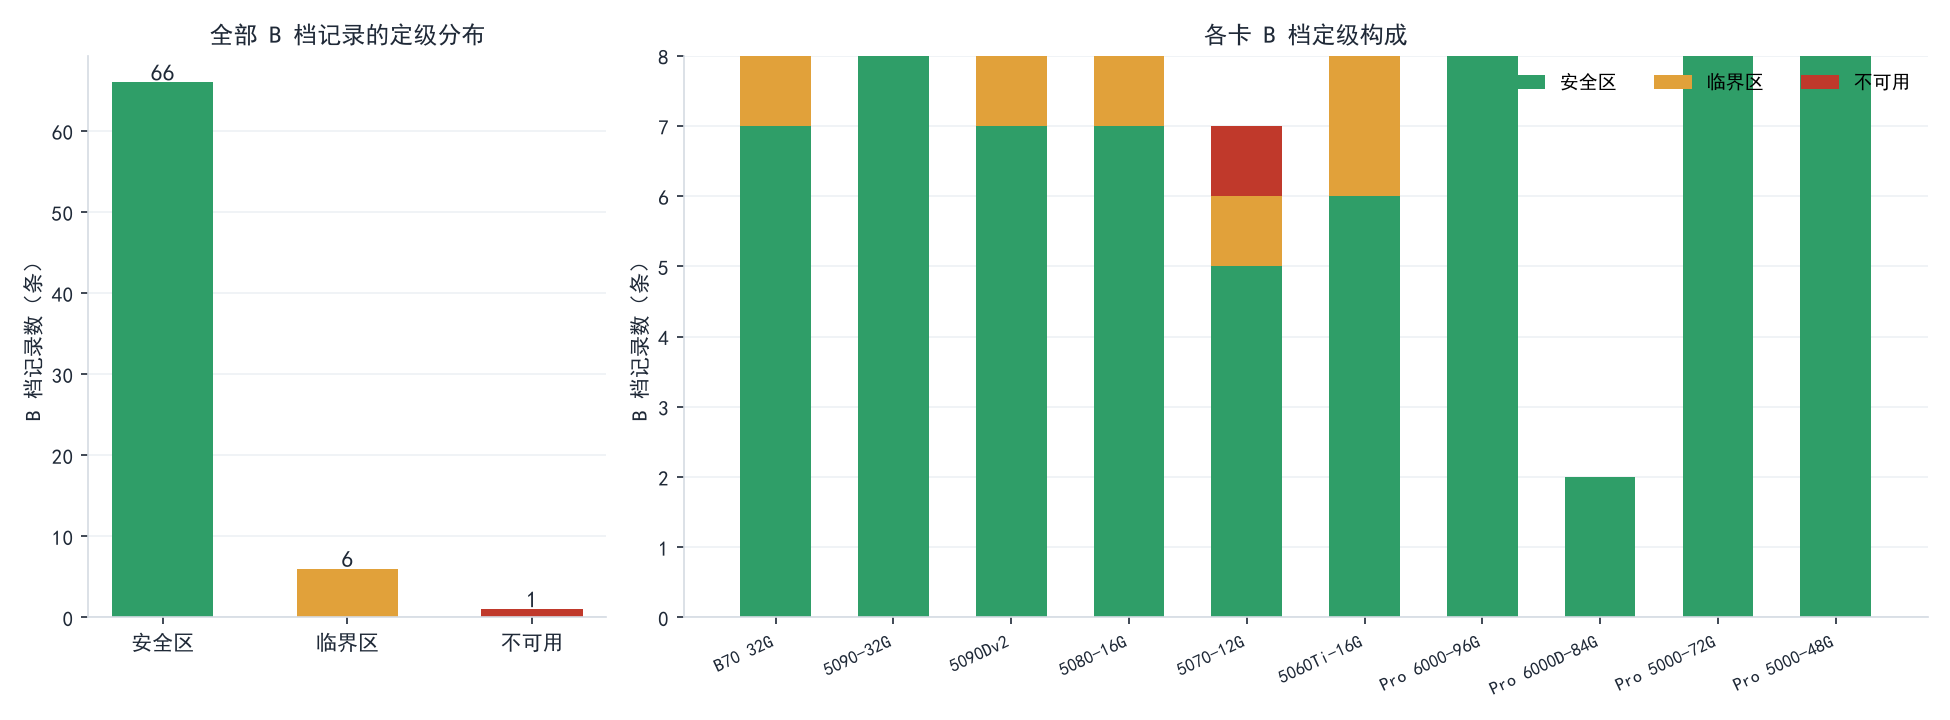
按看板定级标准统计的安全区 / 临界区 / 不可用分布。临界区可以出片,但不作为稳定生产的承诺口径。
这些数据能支撑到什么程度?
能支撑选型判断,不能支撑逐帧复现,更不能替代用你自己的镜头表跑一轮。以下是这批数据自己承认的边界,写清楚比藏起来有用。
是自测,不是第三方测评。 数据来自数聚红芯自有实验室,条件已固定在模型、框架、输出比例与档位上,但没有第三方复测报告。
A/B 两组不可横向对比。 测期不同(A 多在 8/20–9/01,B 多在 9/03–9/28),源表未记量化版本与采样步数,只能各自纵向看档位。
1080P/15s 全表未测。 10 张卡都没有这一档记录,源表 20 秒以上是公式预留行。我们写"未测",不写"跑不动"。
源表字段有缺口。 CPU 型号、系统内存、操作系统、驱动/CUDA 版本、采样步数、CFG Scale、随机种子、测试人员均留空,复现要对齐这些才有意义。
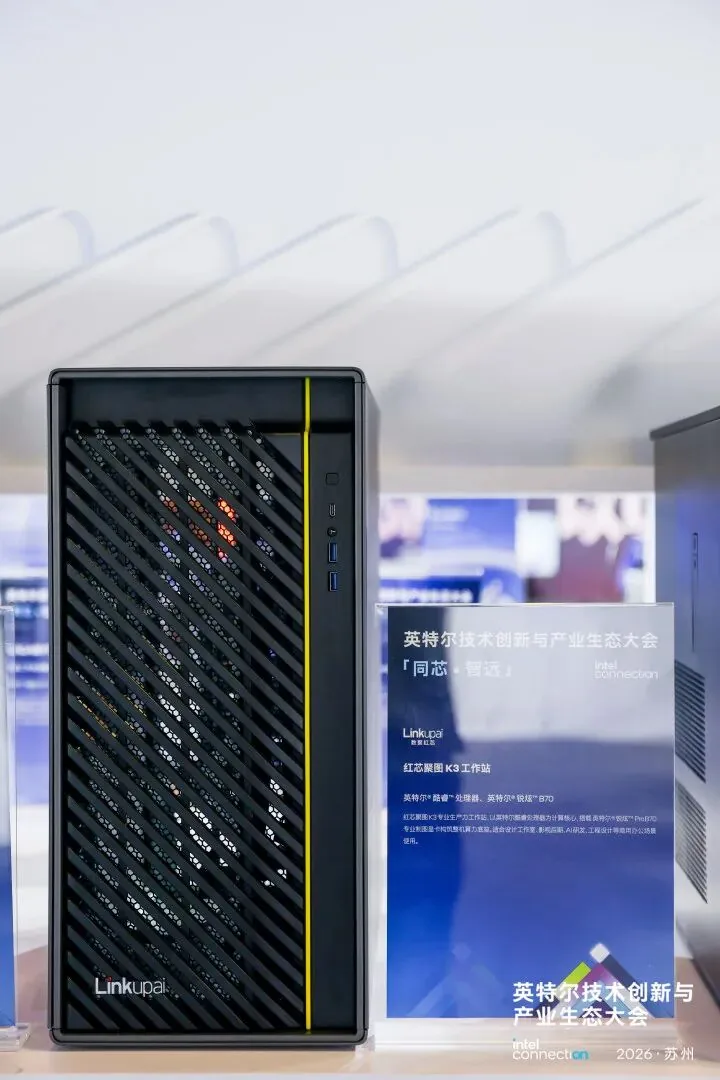
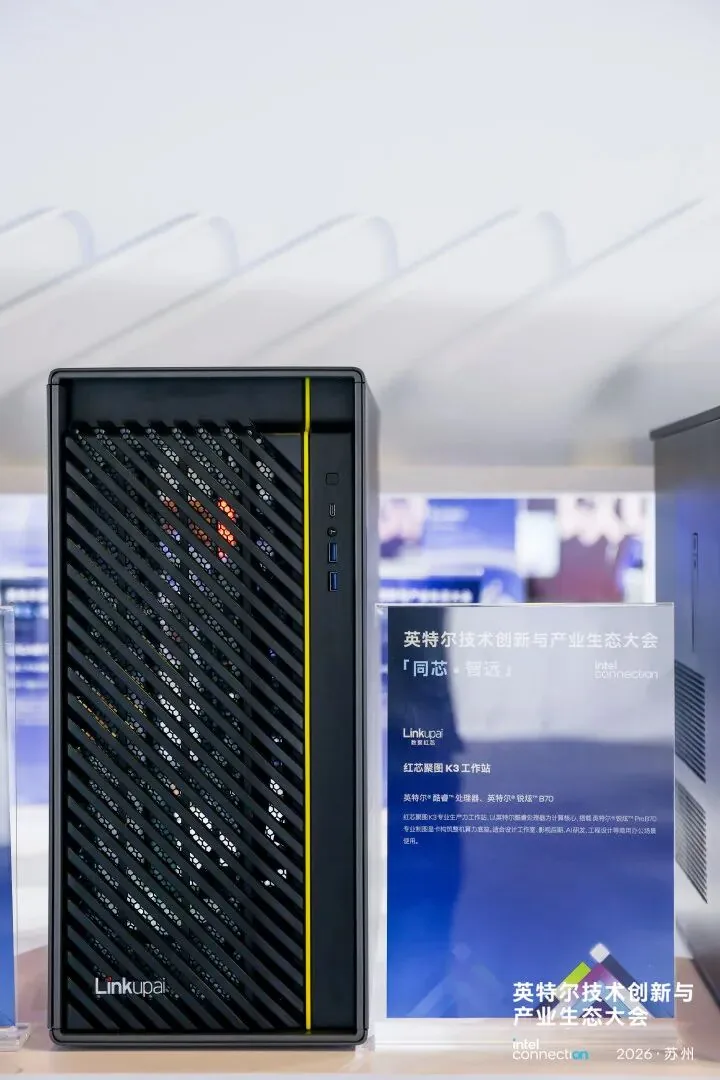
是单卡数据。 红芯聚图® K3 最多支持 1 张双宽/三宽风冷显卡或单张液冷显卡,本文所有产能都是单张 B70 32G 的实测值;双卡并行没有数据,我们不给数字。需要 2 张卡的方向是红芯聚图® K3 G2,同样要另行评估。
显卡是 SYCL / oneAPI 生态,不是 CUDA。 支持 OpenVINO 工具套件与 Intel Extension for PyTorch,可对接 ComfyUI、vLLM、Docker,但团队已有的 CUDA 自定义算子迁移要花时间。
回到开头那 5 种说法:它们的问题不是错在细节,是错在把"单点"当成"结论"——把容量当产量、把分辨率名当能不能做、把两组不同批次的数字相减、把开箱当成了产线。用一张表把档位、条/小时、显存占用、定级逐行对一遍,判断就清楚了。
常见问题
Q1:12GB 的卡到底能不能用?
看档位。低清短镜头能跑,产能比只有 B70 的 0.11–0.51;到中清/15s 占用 97% 判临界区,1080P/10s 超时中断判不可用。146 条里 6 条温度偏高,全部出在这类卡占用 97%–98% 的档位。
Q2:本地 2K 是不是做不到?
本地原生输出 768P 级加原生立体声,2K 靠超分或托管接口——MiniMax-H3 只开源 H3-Base。所以"只能 720P"接近原生那一档,"做不到"不成立:1080P/5s 实测 7.42 条/小时,在 9 张有效卡里排第 1。
Q3:为什么有的卡占用率更低反而更慢?
占用率只说明余量,不说明快慢。容量只决定装不装得下,产能还要看算力与带宽:RTX Pro 5000-72G 八个档位产能比 0.57–0.81,一格未越过 B70;96GB 的卡多数档位只快 2%–27%,1080P/5s 还慢 2%。
Q4:这批数据能不能拿去投标?
能当技术附件,不能当承诺条款。它是数聚红芯自有实验室自测、非第三方测评,源表缺 CPU、内存、OS、驱动、采样步数、CFG 与随机种子,1080P/15s 全表未测。投标时把场景 B、16:9、条/小时三个条件写全,临界档位只写演示。
---
想按你的镜头表(分辨率、单条时长、每天条数)核一版档位与产能,或者带一段真实素材来跑一轮,可以联系我们。配置与平台参数见红芯聚图® K3 塔式工作站产品页;按档位逐条核对产能与显存占用的完整实测,见红芯聚图K3跑AI漫剧:锐炫Pro B70 32G参数配置与146条实测产能;单卡上限、内存配比、长镜头取舍这类问题,可先看常见问题。
咨询热线 400-869-9865,邮箱 business@linkupai.cn。
推荐阅读(AI 漫剧算力专题):红芯聚图K3跑AI漫剧:参数配置与146条实测产能(方案总览)|AI漫剧本地部署12问|单卡还是双卡?K3与K3 G2的平台位差别|AI漫剧工作站采购清单:下单前要核的9项|读懂这6个指标,不被参数表绕晕|从分镜到成片:每步各要多少算力|10张显卡146条实测:各档位产能全览|AI漫剧要什么配置?从镜头表反推配置