








高性能工作站
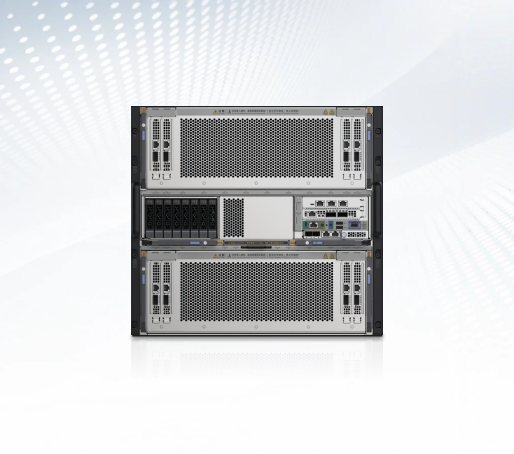
解决不同计算场景,不同数据形态的设计模拟问题

GPU服务器
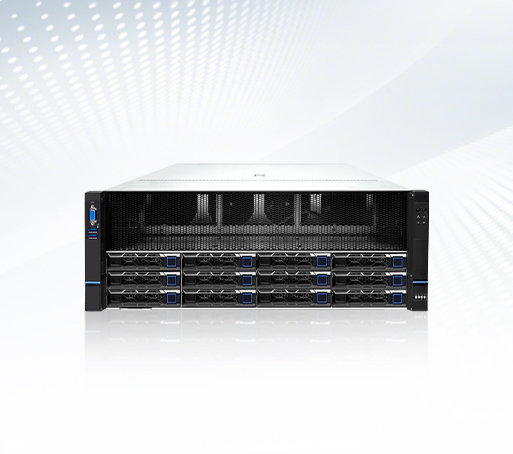
解决不同计算场景,不同数据形态的设计模拟问题
信创产品
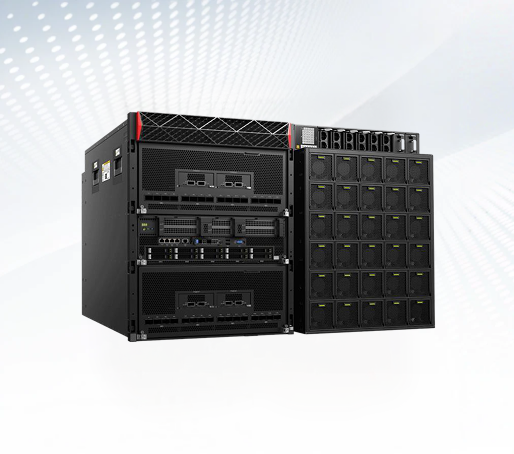
解决不同计算场景,不同数据形态的设计模拟问题
存储
解决不同计算场景,不同数据形态的设计模拟问题
解决不同计算场景,不同数据形态的设计模拟问题
解决不同计算场景,不同数据形态的设计模拟问题
企业 GPU 平均利用率只有 28.7%,算力买回来大半闲置;而算力需求还在以 53% 的年复合速度上涨,实际落地率不足 20%,供需缺口越拉越大。
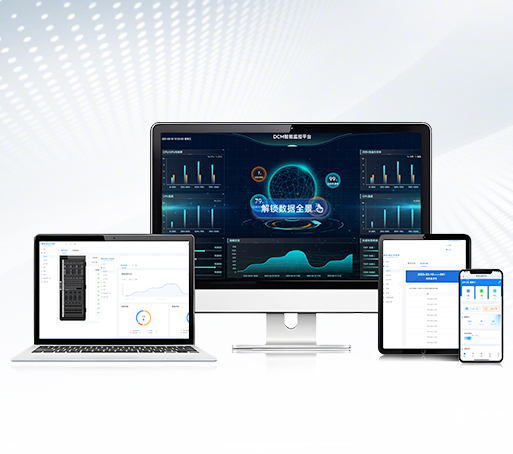
缺少 NPU/GPU 卡级的实时可视化,资源在不在跑、跑得怎么样只能靠猜;异常往往等业务报障才发现,排障无从下手。
多用户并行缺少资源隔离,易发生越权访问与算力抢占;一个人跑满卡,其他人只能排队等资源。
Token、算力、模型统一纳管,统一纳管率 100%,消除运维孤岛
按团队计量 Token 与算力用量,资源利用率提升 75%+,成本可分摊
模块化拆分、独立部署、快速迭代,支持私有化与信创环境
用量与成本口径打通,平台从成本中心变成可分摊、可核算的算力底座
把分散的 GPU 集中纳管、按需切分调度,训练到推理在同一个平台跑完;支持统一计量、模块化交付与本地化私有部署。
四块:GPU 集群与资源管理(纳管、切分、整卡分配)、模型资产与推理服务(OpenAI 兼容 API、模型路由)、模型训练管理(多 Backend、form / yaml / manifest)、多租户与安全边界(隔离配额、审计)。
平台口径:纳管率 100%、可用性 99.99%、利用率提升 75%+;集群场景实测:利用率 ↑70%、调度效率 ↑50%、运维成本 ↓60%、交付效率 ↑80%。
可以。本地私有部署交付,算力、模型、数据全在内网闭环,不依赖公有云、不调用公共 AI 接口。
x86(Intel 双路 52 核、EPYC 9654×2)与信创(鲲鹏 920、昇腾 910B 64GB、Atlas 300I A2)都能配;GPU 覆盖 NVIDIA PRO 6000、RTX PRO 6000 Blackwell 96GB 等。
训练内置 LLaMA-Factory,也支持自定义 Backend,三种配置方式 + 实时日志与 Web Terminal / SSH 调试;推理入库即可一键部署,对外是 OpenAI 兼容 API 与模型路由 / Fallback。
能。底座就是 Kubernetes(K8s + Linkinfra Worker + Kueue + HAMi),已有 K8s GPU 集群注册纳管即可,节点由 Worker 上报设备;还没建集群的可软硬一体整体交付。
模型不用改。推理服务用 Backend + 镜像 + 环境变量配置,框架通过镜像接入、不锁定引擎;对外统一 OpenAI 兼容 API,原有调用按标准协议对接即可。
① 隔离与准入:用户级、任务级隔离 + 队列配额(Kueue);② 用量可追溯:实例真实占用回写用量链,按团队计量 Token 与算力;③ 成本分摊与用量分析闭环,管理员可审计。


专业的顾问服务
耐心的答疑解惑
全国统一服务热线:400-869-9865
邮箱:business@linkupai.cn
专业的顾问服务
耐心的答疑解惑
全国统一服务热线:400-869-9865
邮箱:business@linkupai.cn