





“工作站配置”这件事,在2026年AI科研、低空经济、生态大模型等场景里,已经不是简单的“CPU+显卡”堆料题,而是一道涉及散热、静音、扩展性和长期稳定性的系统工程题。很多团队在采购前都会纠结:明明按照推荐配置单买回了设备,为什么跑起大模型训练就降频?为什么机房放不下、办公室又吵得没法用?
下面从真实落地案例出发,把工作站配置的核心逻辑拆开讲清楚。
一、搞清楚“工作站配置”与服务器配置的本质差异
在谈具体怎么配之前,得先把概念理顺。工作站和服务器虽然都属于高性能计算机,但设计目标完全不同。
工作站是“工具者”,为单一用户提供强大的本地计算能力,专注于专业任务的精准处理,强调图形处理、计算精度及响应速度
服务器是“服务者”,为网络中的其他设备提供数据存储、计算支持及运行环境,需7×24小时不间断运行,强调并发处理能力
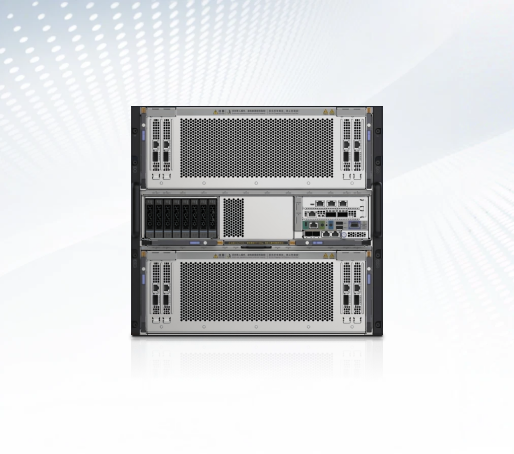
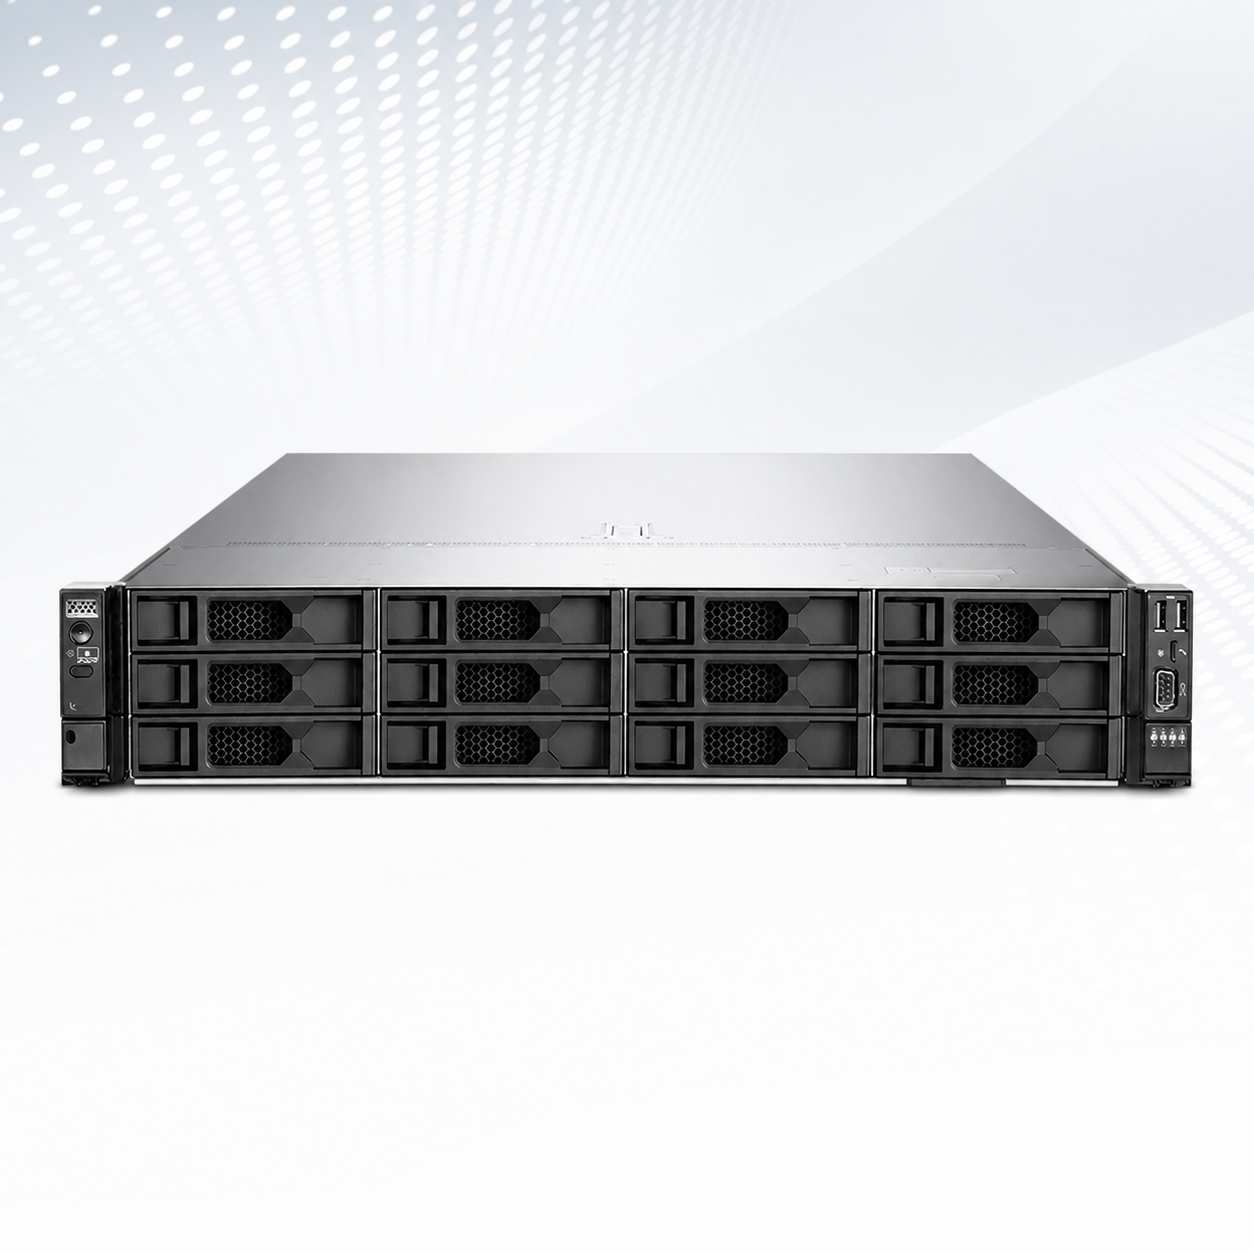
落到硬件上差异更明显:工作站通常采用单路或双路CPU,核心数量适中,主频高,侧重单核性能及低延迟,配备专业图形卡(如NVIDIA RTX A系列等),配备大显存,支持CUDA、OpenCL加速,优化专业软件的图形渲染与计算;服务器则多采用多路CPU设计,核心数量多,主频相对较低,侧重多线程并行处理,内存可支持TB级并配备ECC,存储侧重企业级SSD/HDD与RAID,显卡只需集成或入门级独显。
简单说:工作室里跑仿真、做训练、搞渲染,要的是工作站;机房里跑数据库、做虚拟化、扛多用户并发,才用服务器。把工作站当服务器使,或者反过来,都会导致资源浪费。
二、一套合格的工作站配置,到底要看哪些参数
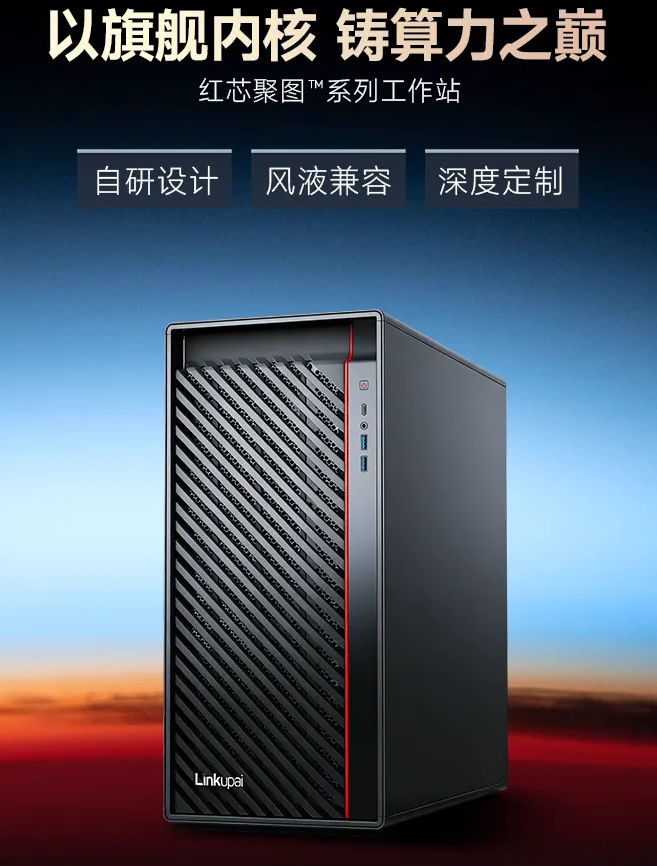
以南方科技大学2026年采购的数聚红芯定制工作站为例(SUSTech-JC-2026-00151 竞采公告),可以反推出科研级AI工作站的配置范式:
处理器:高主频+多核心兼顾
该配置采用24核心48线程处理器,4.2GHz主频,350W功耗,标配液冷散热器。这类规格既能满足多线程并行,又能兼顾单核高主频需求,适配AI计算等场景。
内存:ECC纠错+高带宽
配置128GB(32G×4)Samsung DDR5 RDIMM ECC,4800MHz。ECC内存可实时检测并修复数据错误,保障数据完整性,搭配多通道内存架构,为高负载计算提供带宽保障。
存储:NVMe固态+扩展预留
配置2TB M.2 NVMe SSD(读6000MB/s、写5000MB/s),同时机器最大支持3个M.2硬盘插槽和≥4个3.5英寸硬盘扩展位。高速系统盘负责系统和软件响应,扩展位则为后续数据盘扩容留出空间。
加速卡:大显存AI卡是核心
配置NVIDIA H100加速卡,80GB显存,FP8 Tensor Core算力3200 TFLOPS,INT8 Tensor Core 3200 TOPS,显存带宽2TB/s,采用液冷散热。对于大模型训练/推理,显存容量往往比卡的数量更关键。
网络与扩展
配置1口10Gb电口+1口2.5Gb电口以太网卡,最大支持5个PCIe X16插槽(含2个PCIe 5.0 X16)。高速网口方便数据吞吐,充足的PCIe 5.0通道则为后续升级留出空间。
三、液冷:2026年工作站配置的“分水岭”
如果说上面那些参数是“标配”,那液冷散热就是区分“能跑”和“跑得稳”的关键。
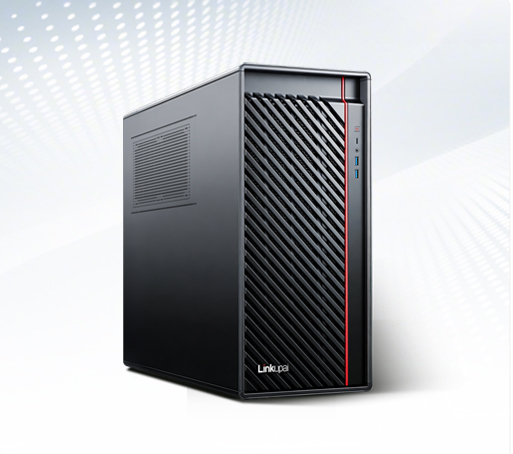
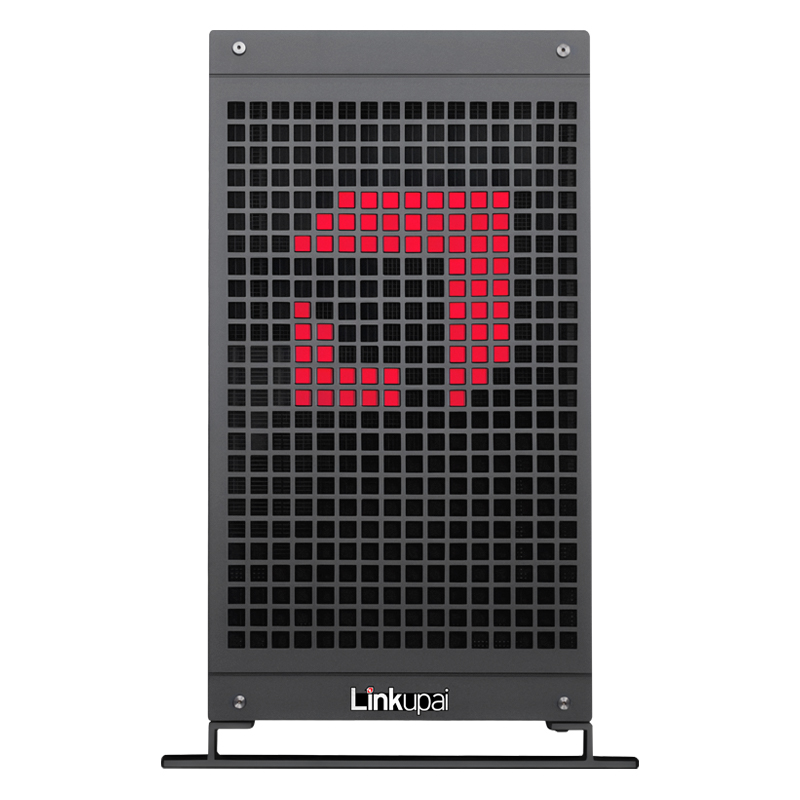
南方科技大学在SUSTech-JC-2025-00203项目中采购的数聚红芯HI5440塔式液冷工作站就是典型代表:
主机:塔式液冷工作站,处理器和显卡均采用液冷散热,主板配置W790芯片组
CPU:英特尔至强w7-3545处理器,24核心48线程,主频2.7GHz,基础TDP 310W
散热:数聚红芯高性能CPU+GPU定制化液冷散热组件,解热能力4000-5000W/(m·k),噪音不大于50dB,全铜冷头,医疗级水泵,生命周期免维护
内存:三星64GB DDR5 4800MHz × 8条
存储:系统盘三星990Pro 4TB M.2 NVMe SSD × 2、缓存盘三星870 Evo 2TB SATA SSD × 1、数据盘西部数据20T SATA 7.2K 3.5寸企业级HDD × 6
盘位扩展:支持最大扩展8个3.5寸盘位,支持4个M.2盘位
液冷的价值不只是降温,更在于让高功耗加速卡长时间满血输出不降频。常规风冷散热能力有限,设备搭载H100等高功耗加速卡长时间开展AI模型训练时,硬件热量无法及时散出,升温后显卡自动降频运行,大幅拉长实验周期。而液冷方案让CPU运行温度降幅超5℃,彻底杜绝高负载GPU降频问题。
另一个被忽视的指标是噪音。传统风冷工作站满载噪音约80分贝,而采用CPU+GPU一体式分体液冷的HI5440,运行噪音下降至50分贝以内,达到图书馆静音使用标准——这意味着它可以真正部署在办公室、教研室,而不是只能扔在远离人群的机房。
四、三个真实落地场景,看工作站配置如何因地制宜
场景1:南方科技大学——高密度AI计算+静音部署
南科大在科研设备采购阶段,面临高密度AI计算、办公区静音部署、长效售后保障三项核心诉求。最终选用的定制版HI5440液冷工作站,搭载至强W7-3545处理器与H100 80G加速卡,采用CPU+GPU一体式分体液冷方案。
落地后的实测效果:
运行噪音从约80分贝降至50分贝以内
液冷散热让CPU运行温度降幅超5℃,彻底杜绝高负载GPU降频
AI计算性能整体提升10%
对应设备中标金额34.9万元(2026年SUSTech-JC-2026-00151项目)
场景2:中国科学院新疆生态与地理研究所——海量遥感+70B大模型
中科院新疆生态与地理研究所是国际干旱区生态与环境领域的前沿科研单位,下设18个专业科研团队,围绕干旱区自然资源开发、生态修复、环境治理、生物多样性保育等重大课题研究。他们的核心挑战是:海量遥感影像特征提取与70B大模型训练推理,对CPU运算速度、GPU并行处理能力、内存带宽要求极高,且科研数据涉及核心研究成果,需保障数据主权与自主可控。
部署方案是数聚红芯HI7440塔式液冷工作站,搭载2×6530 CPU、256GB内存、双液冷5880Ada GPU。创新液冷方案保障了GPU长时间高负载稳定运行,运行噪音低至50分贝以下,并提供全栈本地化算力集群与专业运维服务,彻底解决了数据主权、计算稳定性与模型训练效能三大核心问题,推动科研模式从“传统分析”向“AI驱动”全面升级。
场景3:某航空航天领域企业——双态场景高精度仿真
在低空经济与飞行汽车领域,有企业借助数聚红芯液冷工作站助力飞行汽车双态场景高精度仿真。该类研发对仿真计算的精度与稳定性要求严苛,液冷工作站能在长时间高负载仿真中稳定运行,避免硬件降频,为高精度仿真提供可靠的本地算力支撑。
场景4:深圳某物联网公司——AI算力本地化部署
深圳某物联网公司在构建本地AI算力平台时,选择数聚红芯高性能工作站,满足其日常AI推理与数据处理需求。对于这类企业,工作站配置的核心诉求是:在办公环境内获得充沛算力,同时不需要专门机房建设,降低综合拥有成本。
五、2026年采购工作站配置的四条实操建议
按任务类型倒推配置,别盲目追高
跑大模型训练/推理 → 优先大显存加速卡(如H100 80GB);跑CAE仿真/三维渲染 → 优先高主频CPU+专业显卡;多任务并行数据处理 → 优先大容量ECC内存。
液冷在2026年已经从“可选项”变成“必选项”
只要配置中包含高功耗加速卡,风冷几乎必然面临降频问题。液冷不仅解决散热,还能把噪音压到50分贝以下,让工作站真正进入办公环境。
扩展性预留比“当下够用”更重要
AI算力需求增长极快,采购时要确认:PCIe 5.0插槽数量、内存最大扩展容量、M.2与3.5寸盘位数量、电源余量。数聚红芯HI5440支持最大扩展8个3.5寸盘位和4个M.2盘位,就是为后续扩容考虑。
国产工作站已经具备替代能力
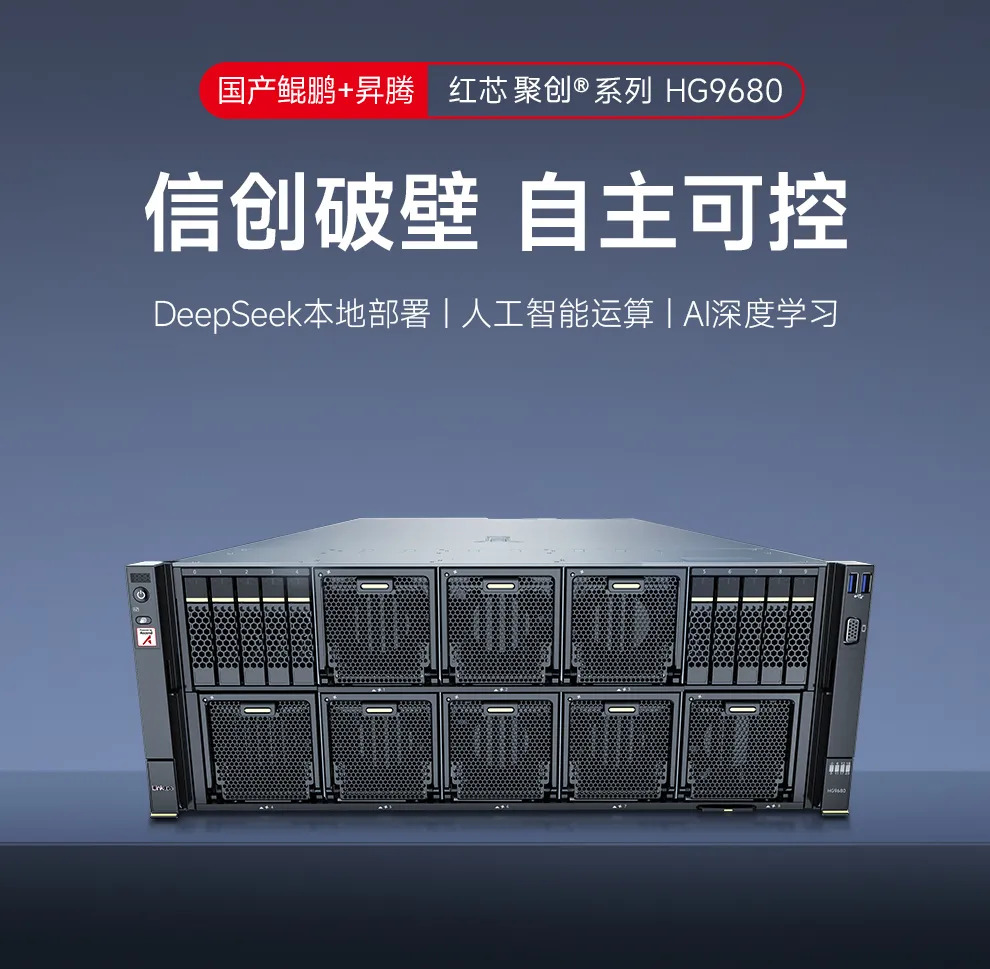
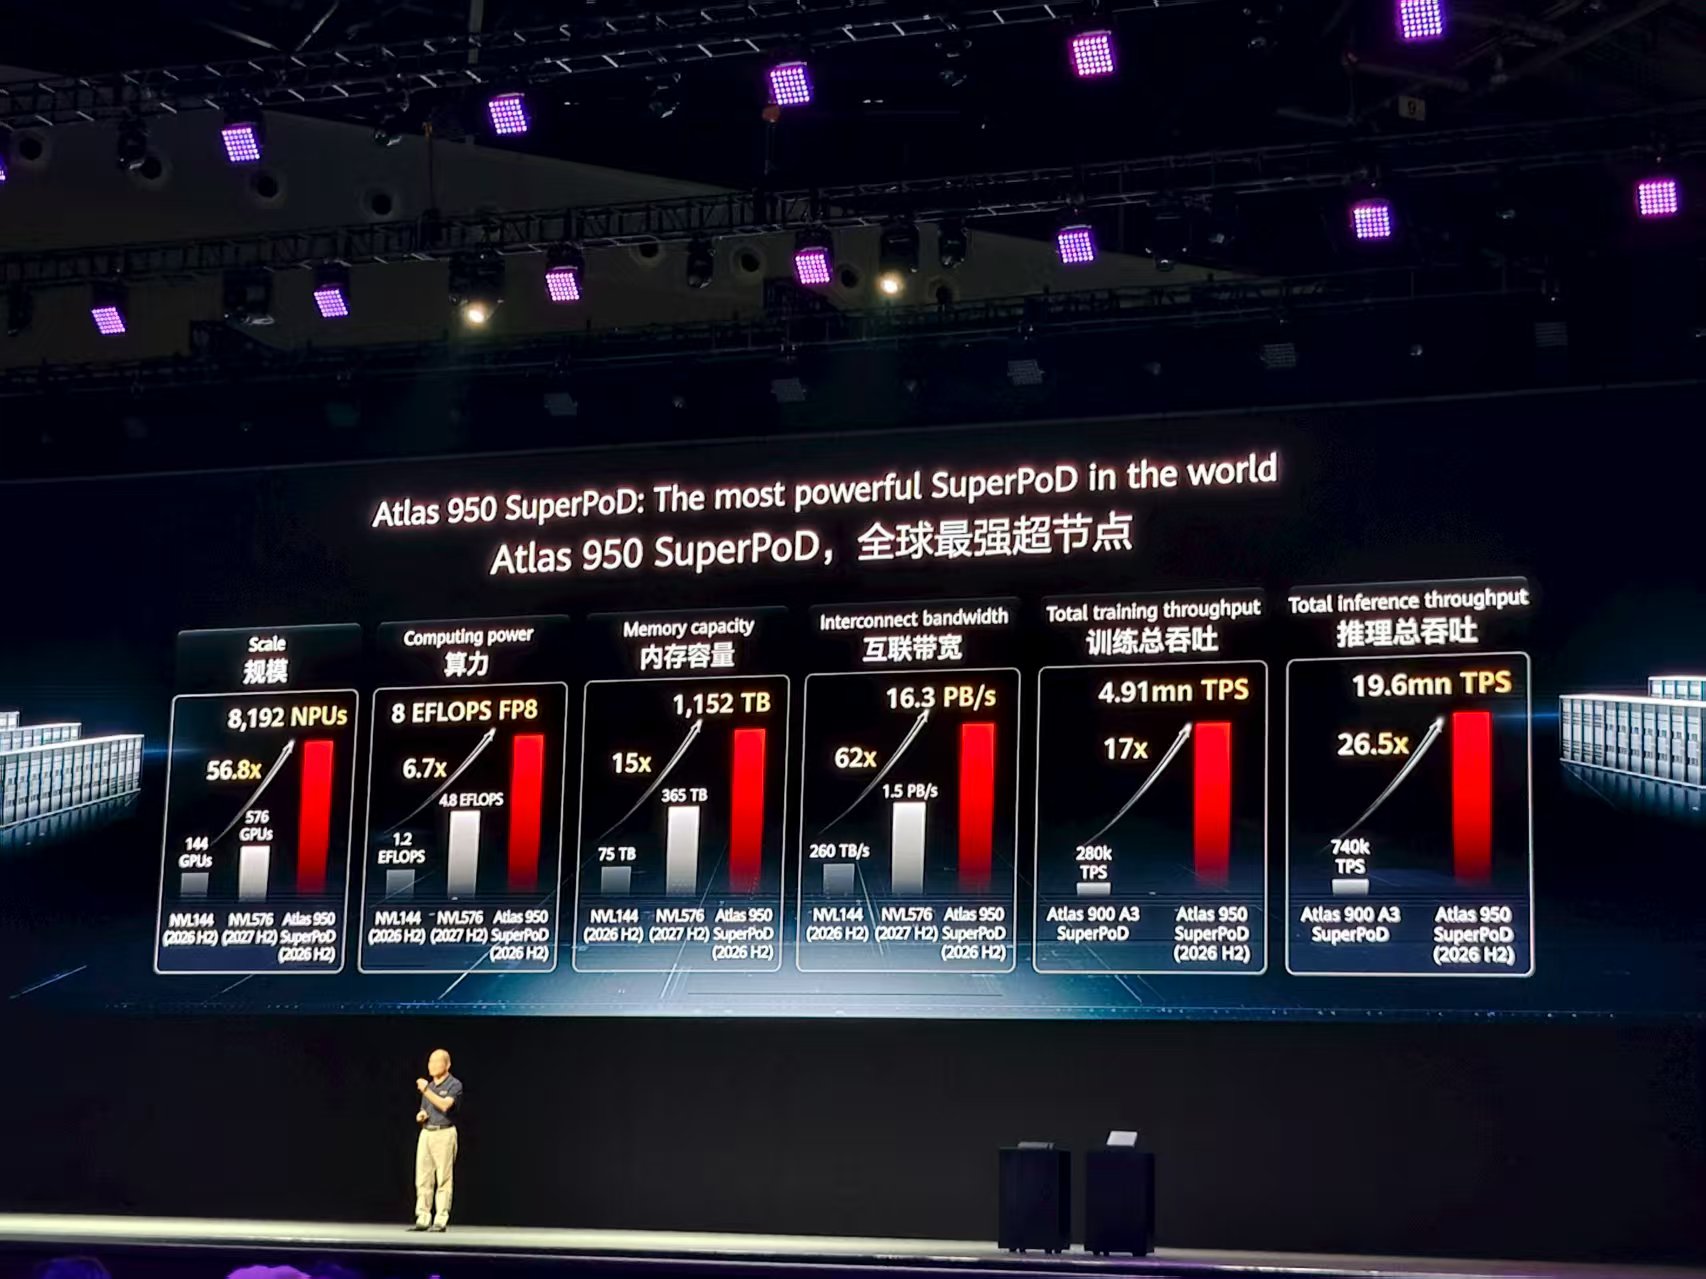
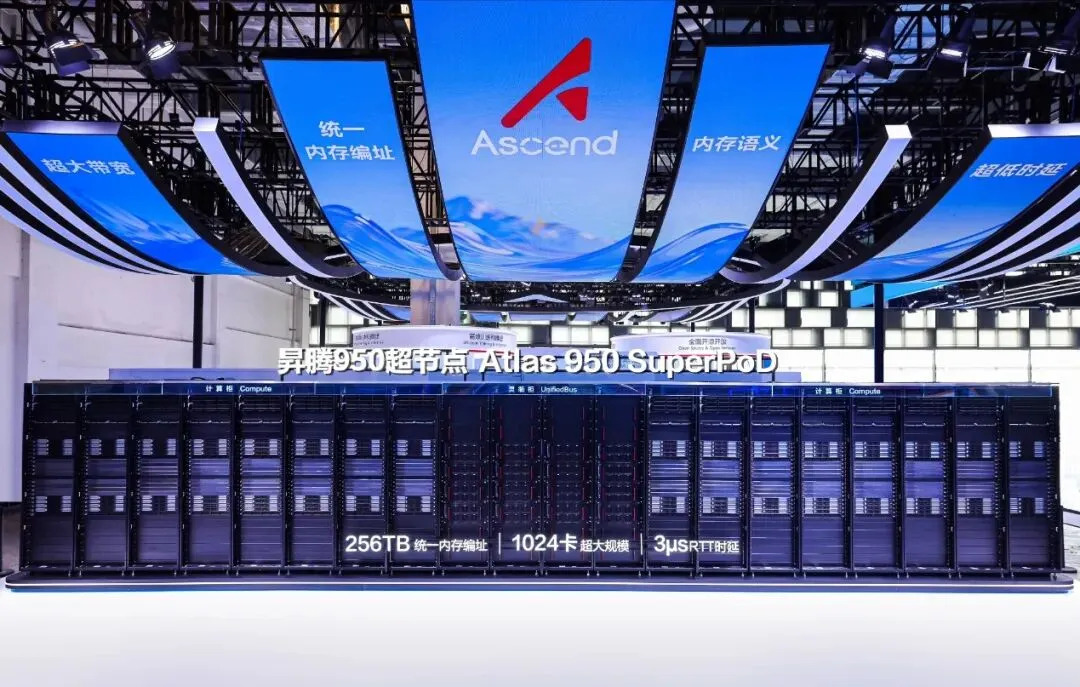
从南科大的竞采结果看,数聚红芯工作站以拒绝进口的国产身份、通过最低价成交方式中标,且配置参数完全对标国际品牌。叠加数聚红芯与华为的深度合作背景,在信创适配、昇腾路线等方面具备天然优势,适合对自主可控有要求的科研与涉密单位。
Q&A:2026年工作站配置采购常见问题
Q1:2026年9月采购工作站,H100加速卡是不是唯一选择?如果拿不到H100怎么办?
A:H100是目前大模型训练的主流选择,但并非唯一。如果供应链受限,可以考虑同代次的其他大显存加速卡(如5880Ada等),关键是显存容量≥80GB、支持液冷散热。数聚红芯HI7440就提供双液冷5880Ada GPU的配置方案,在中科院新疆生态与地理研究所的70B大模型训练场景中已经得到验证。此外,对有信创要求的单位,也可以评估数聚红芯与华为深度合作背景下的昇腾路线方案。
Q2:办公室场地有限,又需要跑高密度AI计算,工作站配置怎么平衡噪音和性能?
A:核心答案是“液冷+塔式”。以数聚红芯HI5440为例,采用CPU+GPU一体式分体液冷后,满载运行噪音可控制在50分贝以内,达到图书馆静音使用标准,可以直接放在办公室或教研室。相比之下,传统风冷工作站满载约80分贝,必须单独隔开;而服务器通常70-85分贝且为机架式,必须进机房。如果场地确实只能放办公室,液冷塔式工作站几乎是唯一选择。
Q3:科研机构采购工作站,除了参数还要关注什么?
A:三点很关键。一是售后响应,液冷系统虽然免维护,但一旦故障需要厂商快速上门,数聚红芯提供标准化售后体系保障连续性科研实验;二是扩展性,确认PCIe 5.0插槽、内存和硬盘最大扩展能力,避免2-3年后算力不够又得重新采购;三是合规与自主可控,拒绝进口的国产工作站(如南科大项目中标机型)在信创适配、数据主权方面更有保障,数聚红芯与华为的深度合作也为后续昇腾路线升级预留了空间。