





昇腾950 和英伟达 H200、B200 之间,没有一句"差多少倍"能直接回答。原因是同一句"差多少倍",在单颗芯片、单个机架、超节点、集群四个层级上算出来可能差两个数量级。所以这篇文章不给"谁更强"的结论,只做三件事:把口径对齐、把迁移边界划清、把"你这个项目该选谁"的判据给出来。
先说一句前置的话:搜"昇腾950 对比"的时候,结果里常常混进英伟达 2015 年的 GTX 950 / 950M 显卡,甚至 32UL950 这类显示器型号——型号数字撞了车。快速判断的办法是看页面里有没有 Ascend、NPU、CANN、Atlas 这组同族词,缺了就不是你要找的东西。至于"昇腾"被写成"升腾"、以及"昇"这个字本身的歧义,本系列第 2 篇已经单独讲过,这里不重复。
一、"差多少倍"这句话,先问它比的是哪一层
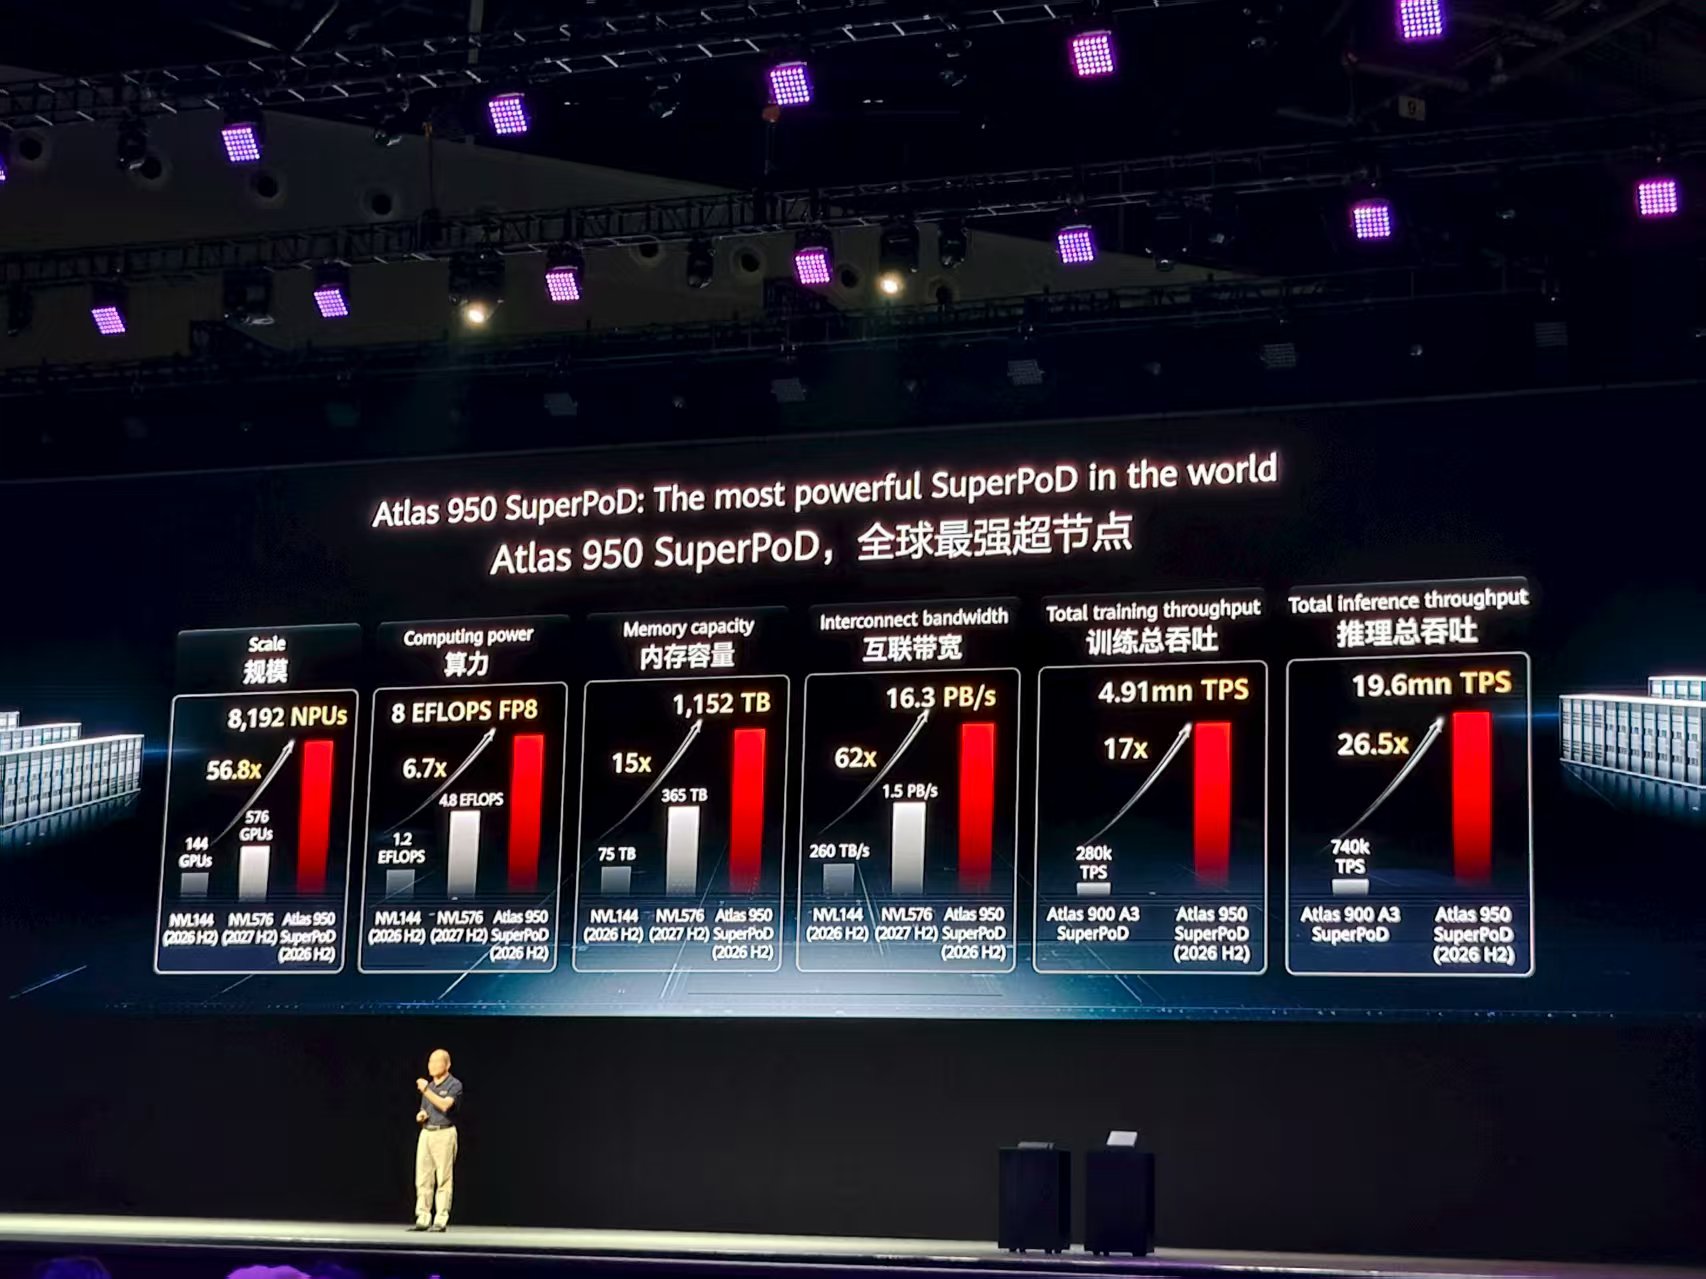
四个层级里,只有前两层具备"同级比较"的条件,后两层存在层级错位:
| 对比口径 | 昇腾950(官方公开) | 英伟达(官方公开) | 可比性 |
|---|---|---|---|
| 单颗芯片 / NPU | 950DT:96/144GB 片上内存,4 TB/s;FP8 804/919/1034 TFLOPS | H200:141GB HBM3e,4.8 TB/s;FP8 3,958 TFLOPS | 需先对齐架构代次与精度定义 |
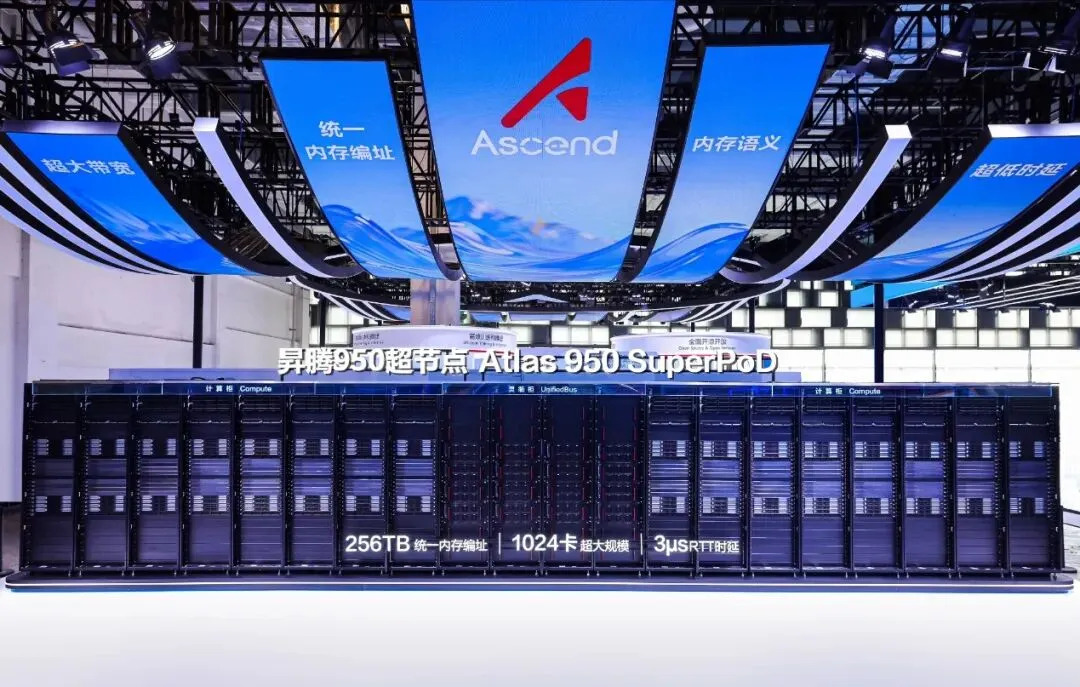
| 单个机架 | Atlas 950 SuperPoD 单计算柜 64 颗 NPU | GB300 NVL72:单机架 72 GPU + 36 CPU | 层级近似,但功耗与形态不同 |
| 超节点(多机柜) | Atlas 950 SuperPoD 满配 8192 颗 NPU(16 计算柜 + 4 灵衢互联柜) | 官方公开的机架级产品为 NVL72(单机架 72 GPU) | 层级不对等,按卡数比会失真 |
| 集群级 | Atlas 950 SuperCluster:超 50 万 Ascend NPU | 官方未公布同层级对照对象 | 暂无可比对象 |
举一个真实存在的口径事故。网上流传一个"56.8"的数字,写它是华为超节点对英伟达 NVL144 的规模比。核对一下:8192 ÷ 144 ≈ 56.9——所以 56.8 是"倍",指的是卡数规模。但这个数字在另一处中文材料里被写成了"56.8%",差了 100 倍。更要紧的是:它比的是卡的数量,不是性能。
你品,你细品——一个规模倍数,被当成性能结论用,再被抄成百分比。这就是为什么"先对齐口径"不是较真,是必需。
二、单卡维度要能比,得先对齐三件事
即便退回到"单颗芯片"这一层,跨厂商直接相除也不成立,至少有三件事要先对齐:
第一,架构代次。 H200 基于 Hopper 架构,GB300 里的 Blackwell Ultra 是更新的代次;昇腾950 系列是华为第三代达芬奇架构的延续。拿不同代次的产品做单卡除法,等于拿两年前的车和今年的车比马力。
第二,精度定义的算法口径。 昇腾白皮书对 950 系列的算力是按精度分档给出的(MXFP4、HiF8/MXFP8/FP8、INT8、BF16/FP16、TF32 各自一档),并且明确标注"算力为大致的范围,非最终值"。英伟达侧同样是按 Tensor Core 精度分列。两边的分档方式和标注口径不同,"FP8 多少 TFLOPS"这句话在两边指的范围并不完全相同。
第三,内存技术。 这是差距最直观也最实在的一栏:H200 是 141GB HBM3e、4.8 TB/s;昇腾950DT 是 96/144GB 自研片上内存、4 TB/s。容量接近,带宽有差距——而带宽恰恰是解码(Decode)阶段的关键约束(这一点在本系列第 2 篇里展开过)。
所以本文的立场是:两侧官方参数可以并列陈述,但不做跨厂商的性能换算结论。 任何把两边数字直接相除得到的"倍数",都不具备工程意义。
三、迁移边界:什么能平移、什么要重做
这是采购论证阶段真正要回答的问题,也恰恰是竞品最常见的两个极端——要么说"完全平替",要么说"生态不行"。按可操作性分四类来谈更实用:
| 边界类型 | 典型情况 | 处理方式 |
|---|---|---|
| 可直接平移 | 主流开源模型与框架的常规算子;已进入 SO 昇腾生态适配清单的模型 | 走标准迁移流程,重点做精度对齐 |
| 需调优 | 自定义算子、融合算子;对通信模式敏感的多机并行配置 | 需要用昇腾的工具链重写与调优,工作量视算子数量而定 |
| 需重写 | 强依赖特定厂商专属库或私有算子的模块 | 先评估必要性,再决定重写还是保留双栈 |
| 建议先验证 | 长稳训练、超大规模并行、时延敏感的推理链路 | 小规模跑通再放量,不要一次性整体切换 |
这里要提醒一句:网上流传的"CUDA 接口兼容比例"数字(如 95%)多来自媒体口径,缺少官方出处,本文不采用。 判断迁移成本最可靠的方式仍然是拿你自己的模型和代码跑一轮。华为侧公开可查的是 CANN 生态本身——昇腾社区提供 CANN 文档、算子开发工具链与兼容性查询工具,白皮书也写明 CANN "全面开源开放,对开发者开放底层能力和提供代码参考"。
所以迁移这件事的准确说法不是"能不能搬",而是"搬之前要算清哪一类占多少"。
四、该选谁的判据:不是谁更强,是谁更合适
这一节是全文最该被拿走的部分。下面四类判断,按顺序问一遍,答案基本就出来了。
第一问:你的负载落在哪个阶段?
如果是推荐的短提示推理或大模型预填充(Prefill),昇腾950PR 这一档的设计目标就在这里;如果是解码(Decode)、长上下文、或全量训练,那是 950DT 的场域。英伟达侧同样按代次与精度区分定位。先把负载对上芯片的定位,再谈品牌。
第二问:你的软件栈依赖有多深?
只跑主流开源模型、用标准推理框架的,迁移成本主要集中在调优;有大量自研算子、强依赖专属库的,要按上一节的四类边界逐条盘。这一步算出来的是工程量,不是技术优劣。
第三问:供货状态能不能撑住你的项目节点?
这是最容易被忽略、却最影响成败的一栏。昇腾侧走的是项目制与授权渠道,需要锁定配置与排期;英伟达在中国市场的供应状态受政策影响,H200 的获批与交付节奏有过多次变化——英伟达在 2026 年 8 月的业绩会上确认 H200 已向中国客户交付,但未披露具体规模。供应确定性在不同时期会反转,采购方案里要留出替代路径。
第四问:你的机房扛得住哪一边?
两边的功率密度都在往上走。昇腾侧官方公开的 Atlas 950 SuperPoD 走全液冷路线、单套供电能力 100kW;英伟达侧的 GB300 NVL72 同样是全液冷机架级平台,DGX B200 单机功耗约 14.3kW。这说明机房条件已经不是"能不能装"的问题——液冷还是风冷、单柜能供多少电、地板承重多少,这些要在选型阶段就算进预算,而不是等设备到场再补。
四问过完,多数项目会落到一个并不戏剧化的结论上:不是二选一,而是按负载分池。 训练与推理、预填充与解码,本来就该分开配。这也正是华为在 2026 中国算力大会上给出的定调——AI 基础设施的竞争"早已从单卡性能的线性比拼,转向集群系统的工程革命"。
五、三种常见的对标误区
误区一:拿规模倍数当性能结论。 8192 卡对 72 卡,是卡数比;两者不是同一层级的产品形态,这个比值说明的是"超节点这一层能连多少卡",不是"谁跑得快"。
误区二:拿不同代次的产品做单卡除法。 昇腾910C 与 B200 常被放在一起比,但两者本就不是同一代产品;同理,把 950 系列与 Hopper 代次直接相除,也会得到没有工程意义的数字。
误区三:只看峰值算力,不看有效利用率。 集群的实际产出取决于互联、内存带宽、软件栈成熟度和故障恢复能力,不取决于峰值除出来的那个数。峰值是纸面天花板,利用率才是地板高度。
六、关于对标,几个常见问题
昇腾950 相当于英伟达什么型号?
不存在一对一的对应关系。两者在架构、精度格式、内存技术和互联协议上都不同构,厂商也没有给出官方映射。更实用的问法是"我这个负载该用哪一档",而不是"它等于哪张卡"。
昇腾950PR 兼容 CUDA 吗?
"CANN 是否兼容 CUDA"这个问法本身需要精确化。华为的路子是提供 CANN 异构计算架构与配套迁移工具链,让主流框架与模型能跑起来,而不是让昇腾去执行 CUDA 代码。具体某个模型或算子的可行性,要按第四节的四类边界逐条验证。
昇腾950 和 H200 哪个更适合 AI 训练?
训练要看的不只是算力:内存带宽、互联规模、长稳训练的稳定性、以及生态里有没有你需要的算子,权重都不低。950DT 定位覆盖解码与训练,H200 是 Hopper 代次的高带宽型号。结论取决于你的模型规模、并行策略和软件栈,不是一个可以脱离场景回答的问题。
国产卡跑大模型训练可行吗?
可行,但边界要说清。推理与微调的迁移成熟度明显高于大规模预训练;超大规模长稳训练仍是需要重点验证的环节。务实的路径是先在推理或微调场景跑通、把工具链和运维经验攒起来,再往训练侧推进。
只看单卡算力选,会踩什么坑?
最大的坑是把峰值当成实际产出。集群规模上去之后,互联带宽、内存带宽和软件栈成熟度的影响会迅速超过单卡峰值。这也是"集群系统的工程革命"这句话的由来。
四问答完,多数项目会落到同一个地方
回到最初的问题:昇腾950 和 H200、B200 怎么比?
先确认比的是哪一层(芯片 / 机架 / 超节点 / 集群),再确认两侧是否同级、同代次、同精度定义,然后才谈数字。 而真正决定选型的,是负载落在哪个阶段、软件栈依赖有多深、供货能不能撑住节点、机房扛不扛得住——这四问,比任何一张天梯图都管用。
论证材料最怕数据来源说不清,配置来源同理。数聚红芯是华为官方认证的昇腾 APN 合作伙伴,做的是昇腾全系模组与整机的供货与交付——910B / 910C / 950PR / 950DT 提供现货库存与预订下单两条通道,一手资源与价格。如果你正在做两边对照的论证材料,可以把负载类型、模型规模、软件栈依赖和机房条件发给我们,我们先按上面四问帮你把适用范围划出来,再给配置与货期方案。
📞 咨询热线:400-869-9865 | 联系我们,提交你的项目条件
同系列相关阅读