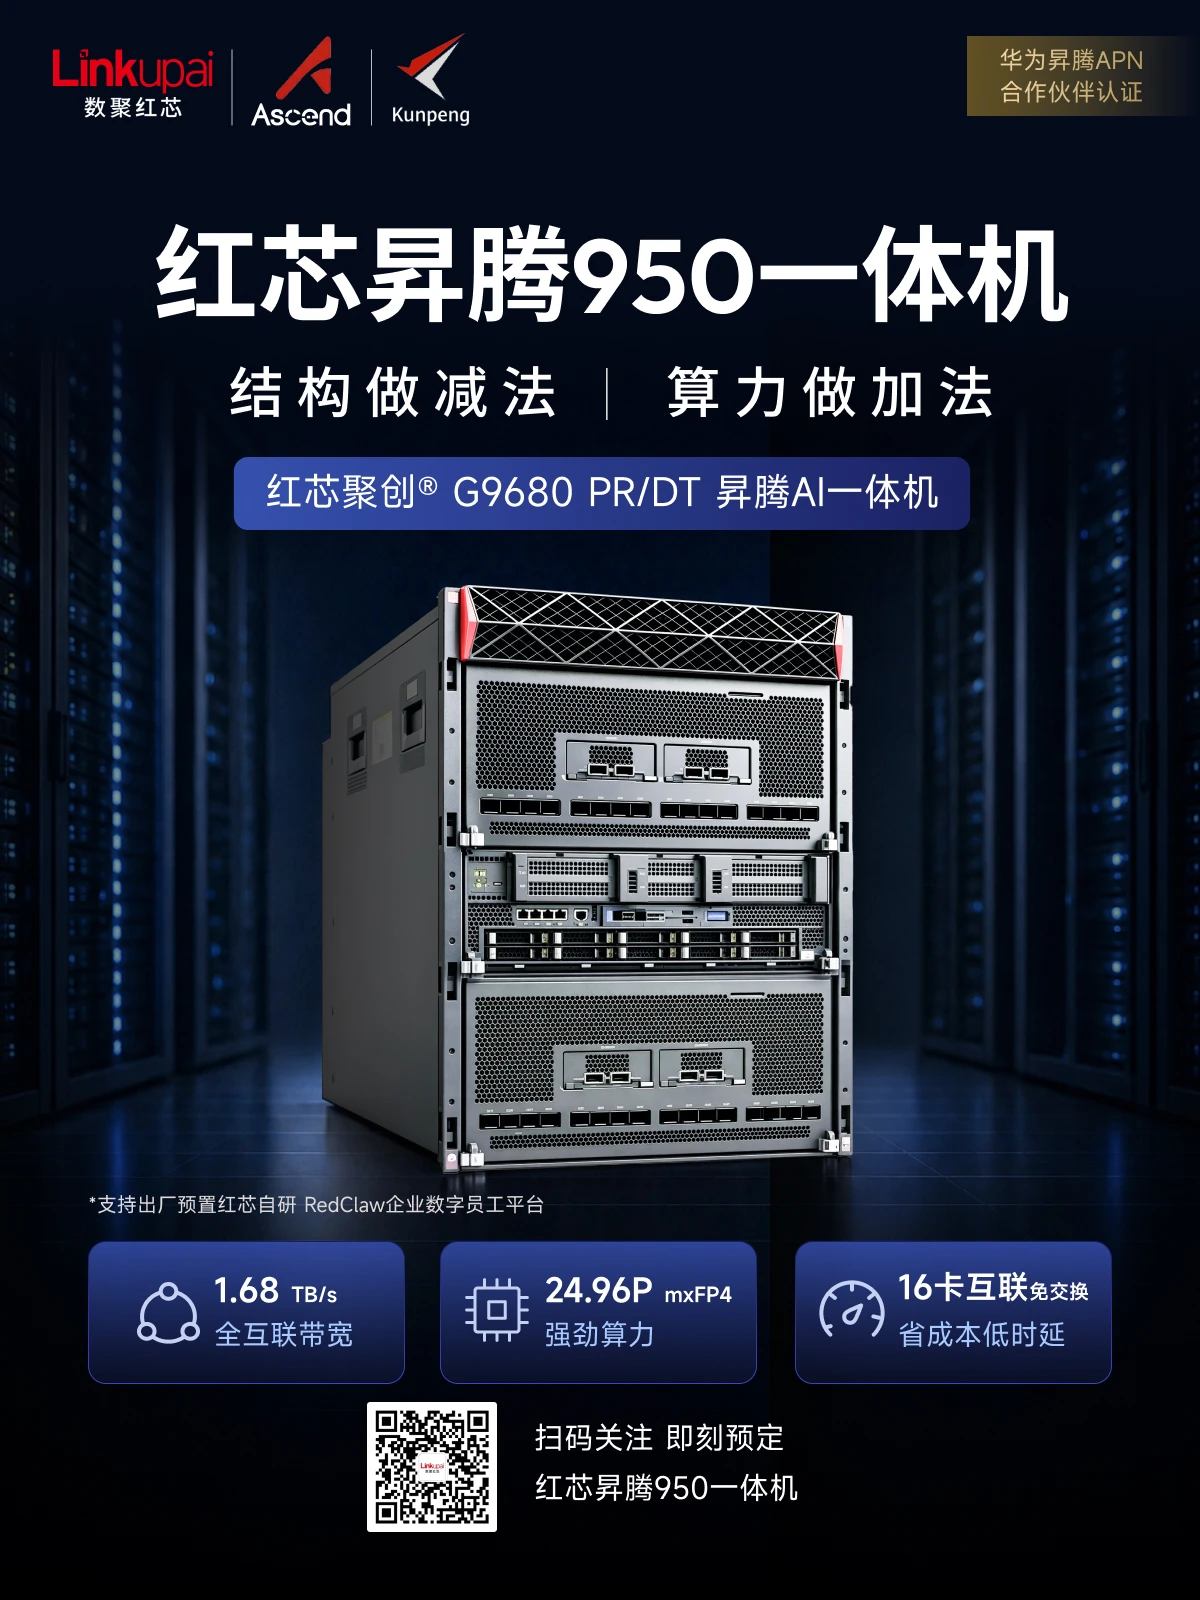




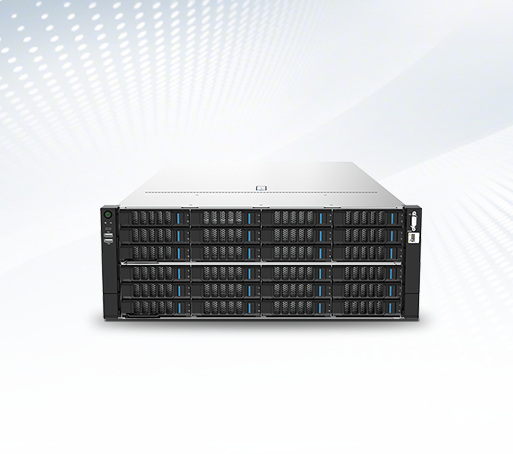
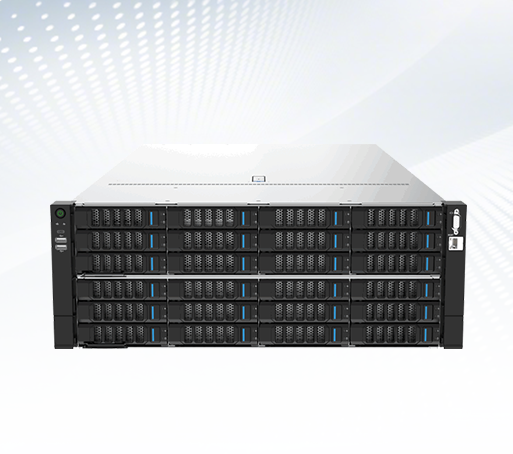
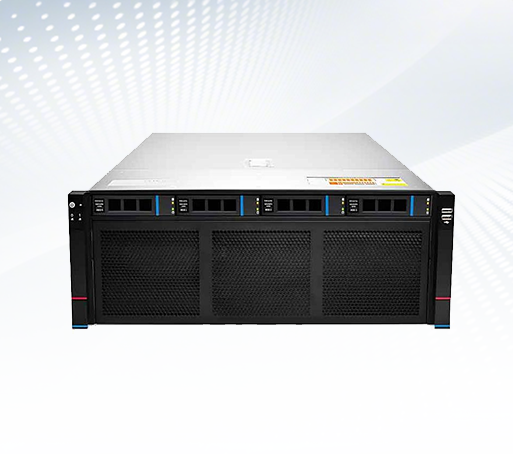
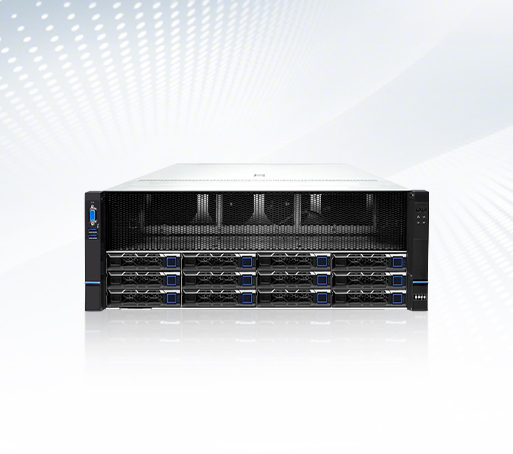
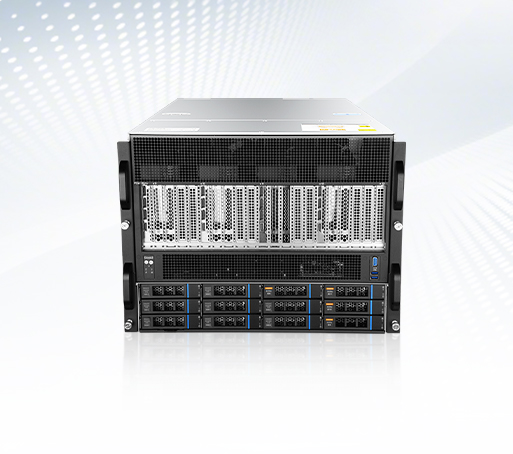
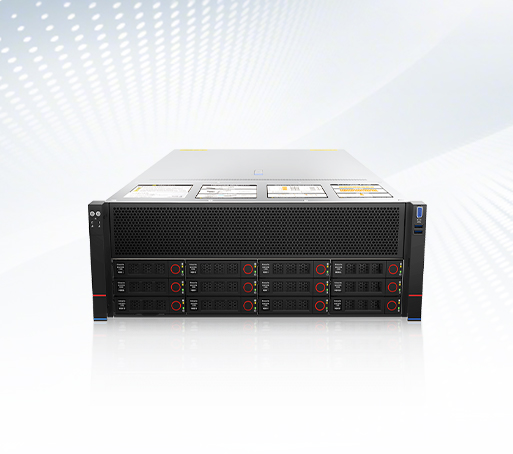
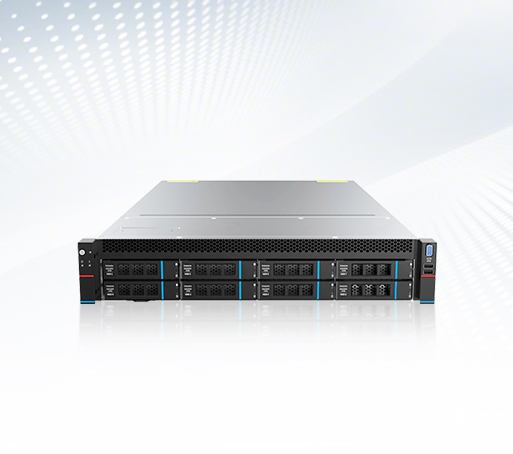
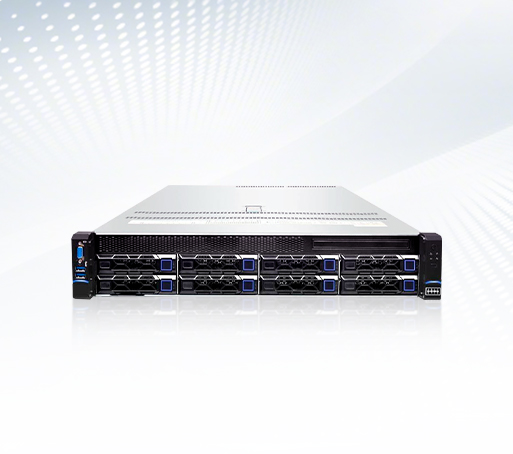
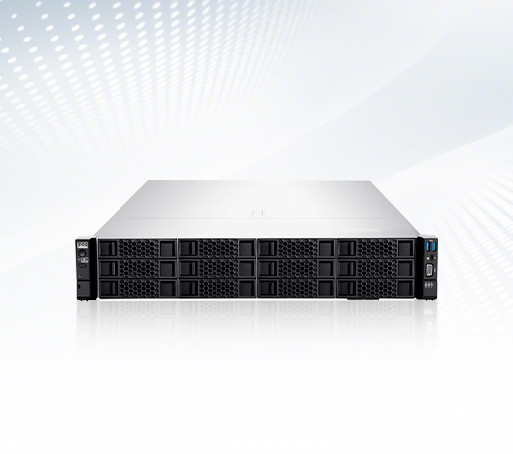
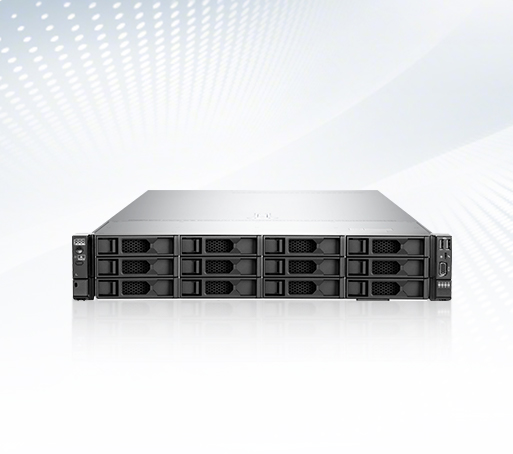
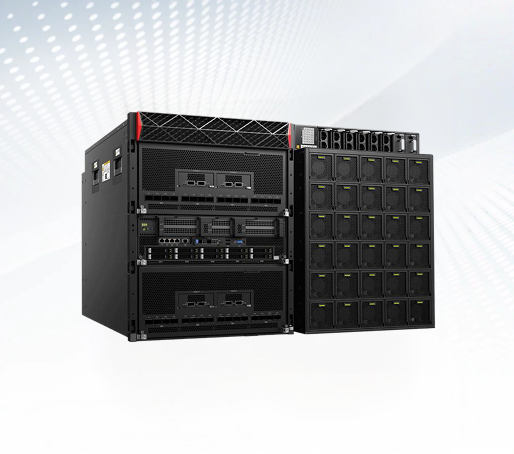
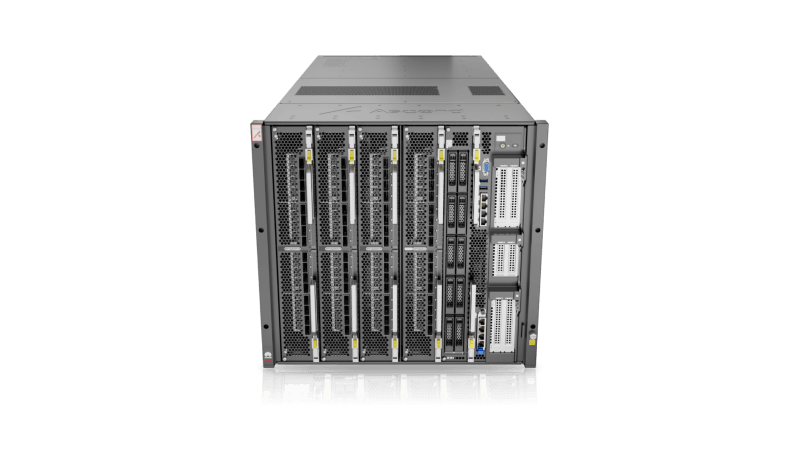


昇腾950PR 和 950DT 不是二选一的关系。它们共用同一颗 Ascend 950 Die,区别只在外挂的片上内存:PR 配 HiBL 1.0、面向 Prefill(预填充)与推荐场景,DT 配 HiZQ 2.0、面向 Decode(解码)与训练场景。真正要在方案阶段定下来的,是一个集群里放几台 PR、几台 DT——也就是配比。而这件事在中文内容里几乎没人讲清楚,先把最常见的四种歧义切开。
一、先切开歧义:你搜到的可能不是昇腾
"950PR""950DT"这几个字符在搜索引擎里至少指向四种完全无关的东西。这不是读者的问题,是命名本身带来的。
| 你看到的 | 实际指向 | 怎么判别 |
|---|---|---|
| "昇"字释义页 | 汉字"昇"的字典词条(读 shēng,同"升") | 页面在讲字形、部首、笔画,与芯片无关 |
| GTX 950 / 950M 显存 | 英伟达 2015 年前后的消费级显卡 | 出现"gtx""950m""游戏显卡"等词即为误匹配 |
| 升腾瘦客户机 | 升腾(Centerm)品牌的终端/云终端型号,如 C92、GI945 | 型号是字母+四位数字,且页面讲终端机、POS |
| "研训一体" | 军事/培训领域的业务术语 | 出现"战训结合""训勤一体"等表述 |
判别方法很简单:认准"昇腾"两个字,并且确认页面里出现 Ascend、NPU、CANN、Atlas 这些同族词。 只要缺了这些,基本可以关掉。
顺带说一句:很多人会把"昇腾"打成"升腾",这两个字在搜索里指向不同主体。本文一律用"昇腾"。
二、PR 和 DT 到底差什么:同一颗芯,两种装法
先说清楚它们的共同点——这点比差异更重要。950PR 和 950DT 不是两款独立设计的芯片,而是同一个 Ascend 950 Die 配不同片上内存:
Ascend 950PR = Ascend 950 Die + HiBL 1.0
Ascend 950DT = Ascend 950 Die + HiZQ 2.0
命名也是场景声明,不是字母代号:PR = Prefill & Recommendation(预填充与推荐),DT = Decode & Training(解码与训练)。
从华为《昇腾950 NPU 架构白皮书》表 3-1 能看出,两者的差异集中在内存这一栏:
| 规格项 | 昇腾 950PR | 昇腾 950DT |
|---|---|---|
| 片上内存容量 | 128 / 112 GB | 144 / 96 GB |
| 片上内存带宽 | 1.6 / 1.4 TB/s | 4 TB/s |
| 总算力 MXFP4 | 1784 / 1561 TFLOPS | 2007 / 1784 / 1561 TFLOPS |
| 总算力 BF16/FP16 | 486 / 425 TFLOPS | 547 / 486 / 425 TFLOPS |
斜杠前是满配档、斜杠后是精简档。白皮书对这一点的说法是——昇腾950PR 与 950DT 会"进一步衍生出多个不同规格的版本,并应用于不同的产品形态中"。翻译成采购语言就是:报价前不锁定档位,报价单就永远是错的。
这张表里最该注意的不是容量,是带宽。 950PR 是 1.6/1.4 TB/s,950DT 是 4 TB/s。容量差 16GB 到 48GB,带宽差 2.5 到近 3 倍。这个差异直接决定了下一节要讲的事。
三、为什么不是二选一:Prefill 和 Decode 是两个完全不同的瓶颈
要让配比这件事成立,得先理解大模型推理被分成了两个阶段,而这两个阶段的负载特性恰好相反。
Prefill(预填充)阶段,用户把一整段提示词一次性提交,芯片要并行地把这整段 prompt 跑完,生成完整的 KV Cache。这一阶段是计算密集的——瓶颈在算力,矩阵乘法量极大,对显存容量的要求主要来自要把整段提示塞进去。
Decode(解码)阶段,模型逐 token 往外生成,每生成一个 token 都要把全部权重和 KV Cache 读一遍。这一阶段是访存密集的——瓶颈在显存带宽,算力反而用不满。
用一句话概括:Prefill 拼的是算力和容量,Decode 拼的是带宽。 这就是为什么需要两种芯片——不是产品线划分,是两个阶段的物理约束不同。950PR 用更便宜的 HiBL 1.0 把 Prefill 的性价比做上去,950DT 用 4TB/s 的 HiZQ 2.0 把 Decode 和训练的带宽墙顶住。
理解这一层,配比就不是玄学,而是一道按负载结构解的应用题。 你的提示词越长、并发越高,P 侧压力越大;你要输出的 token 越多、时延要求越严,D 侧压力越大。
四、"配比"不是行业黑话——昇腾官方文档里就有这一章
这一点特别值得说清楚,因为它把"配比"从经验之谈变成了有官方方法论的工程问题。
昇腾社区的 MindIE Service 开发指南里,有一个独立的文档章节叫《配比调优理论原理》,它的路径是:性能调优 → PD分离部署 → PD配比调优。文档描述的场景是:PD 分离部署下各实例一般加载相同模型,需要决定如何分配实例的初始属性、并按实际需求动态调整,而不合理的实例配比会带来问题。
同时,昇腾官方开源的 MindIE-PyMotor(2026 年 3 月开源)在简介里写明,它"提供一键式 PD 分离与 PD 混部部署,基于云原生插件化架构灵活适配多种推理引擎(vLLM、SGLang)",并分别给出了 PD 分离部署与 PD 混部部署两条文档路径。
换句话说,"PD 分离"和"PD 混部"是昇腾官方支持的两条部署路线,而"配比"是这条路线上的正式调优项。 那么怎么选?
昇腾官方文档《PD分离特性介绍》给了一条很实用的判据:在 decode 平均低时延约束的场景,PD 分离相比 PD 混合部署更能够发挥性能优势。
反过来读这句话就是:分离不是无条件更优。 如果你的场景对 decode 时延不敏感、并发不高,PD 混部的部署复杂度和资源占用反而更低。这一条判据能帮你省掉一轮试错。
五、按规模分三档:配比怎么定
把前面几层收拢成一个可操作的框架。下面三档是按集群规模划分的,每一档对应一种部署模式和一套机型组合。
| 档位 | 规模 | 部署模式 | 机型组合 | 适用 | 不适用 |
|---|---|---|---|---|---|
| 入门档 | 单机~双机(8~16 卡) | PD 混部 | Atlas 650(950PR)为主 | 百亿级模型推理、并发较低 | 长上下文、低时延要求高的场景 |
| 进阶档 | 多机(16~64 卡) | PD 分离 | Atlas 650E(950DT)+ Atlas 650 / 750(950PR) | 千亿级模型、Agent 多轮对话、低时延 | 只跑推荐类短提示推理 |
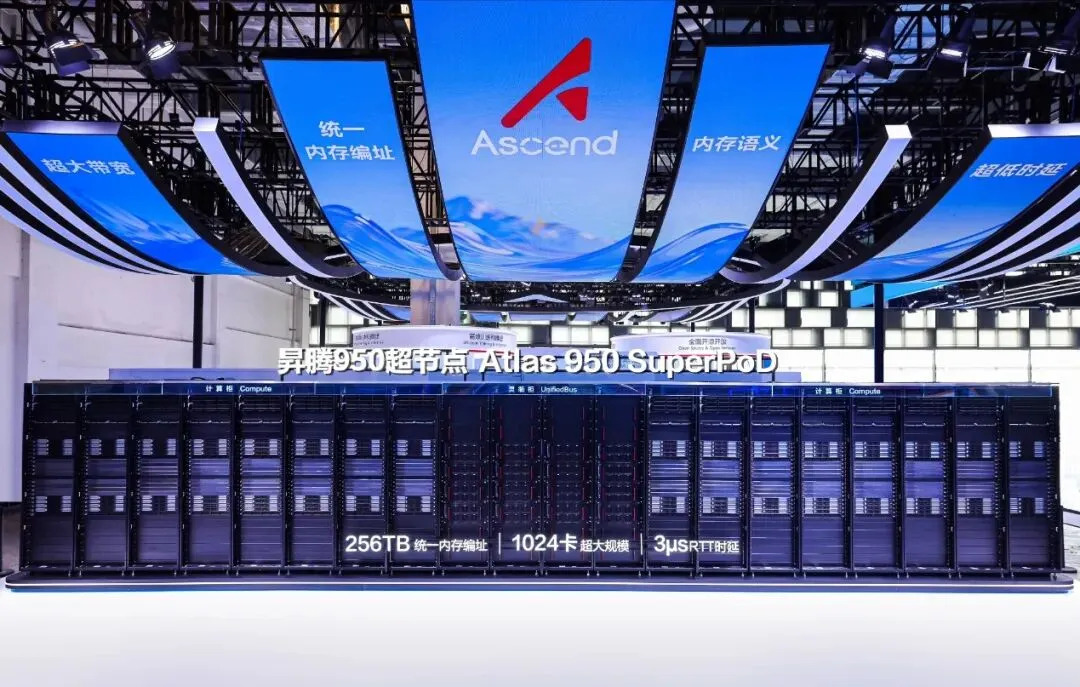
| 旗舰档 | 超节点(96~1024 卡起) | PD 分离 + 超节点统一编址 | Atlas 850E 风冷 / Atlas 950 SuperPoD 液冷(950DT) | 万亿级训练 + 高并发推理一体 | 存量风冷机房且无扩容计划 |
必须强调一点:表里的配比是"档位框架",不是固定比例。 P 池和 D 池的实例数要按你的提示长度分布、并发数和时延目标来调——同样是千亿级模型,做长文档问答和做短提示分类,P/D 的合适比例会完全不同。这也是为什么昇腾要在 MindIE 文档里单开一章讲"配比调优"。
一个务实的建议:不要在第一版就把比例写死。 先按档位把机型买对,留出可调整的实例数空间,用真实负载跑一轮再定比例。昇腾官方文档本身也把这描述为"按实际需求动态调整"的过程。
六、机型层面怎么落地:先认型号,再谈配比
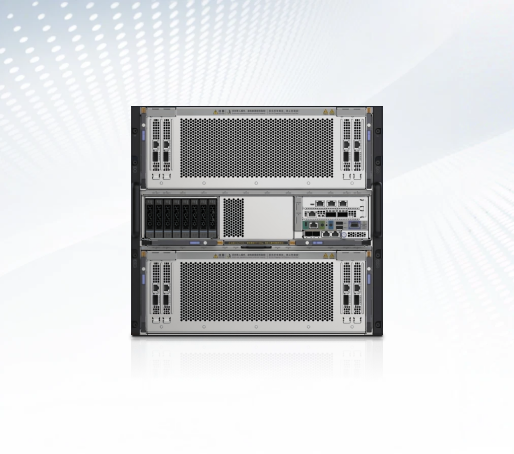
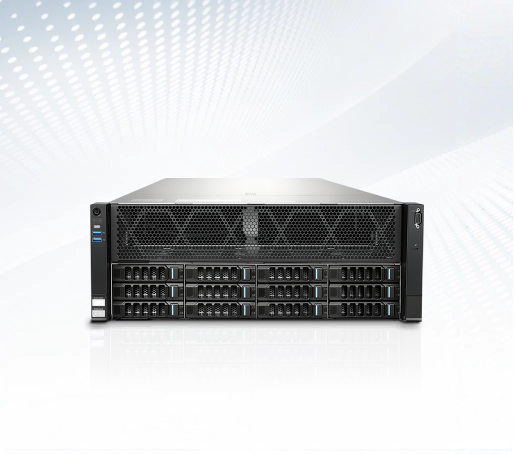
配比最终要落到具体机器上。昇腾950 系列的产品形态从单张标卡一直延伸到超节点:
这里有一个现场最实用的口诀:服务器型号带 E 的用 950DT 芯片,不带 E 的用 950PR 芯片。
按这个口诀对照,配比的地图就很清楚了:
| 机型 | 芯片 | 在配比里的角色 |
|---|---|---|
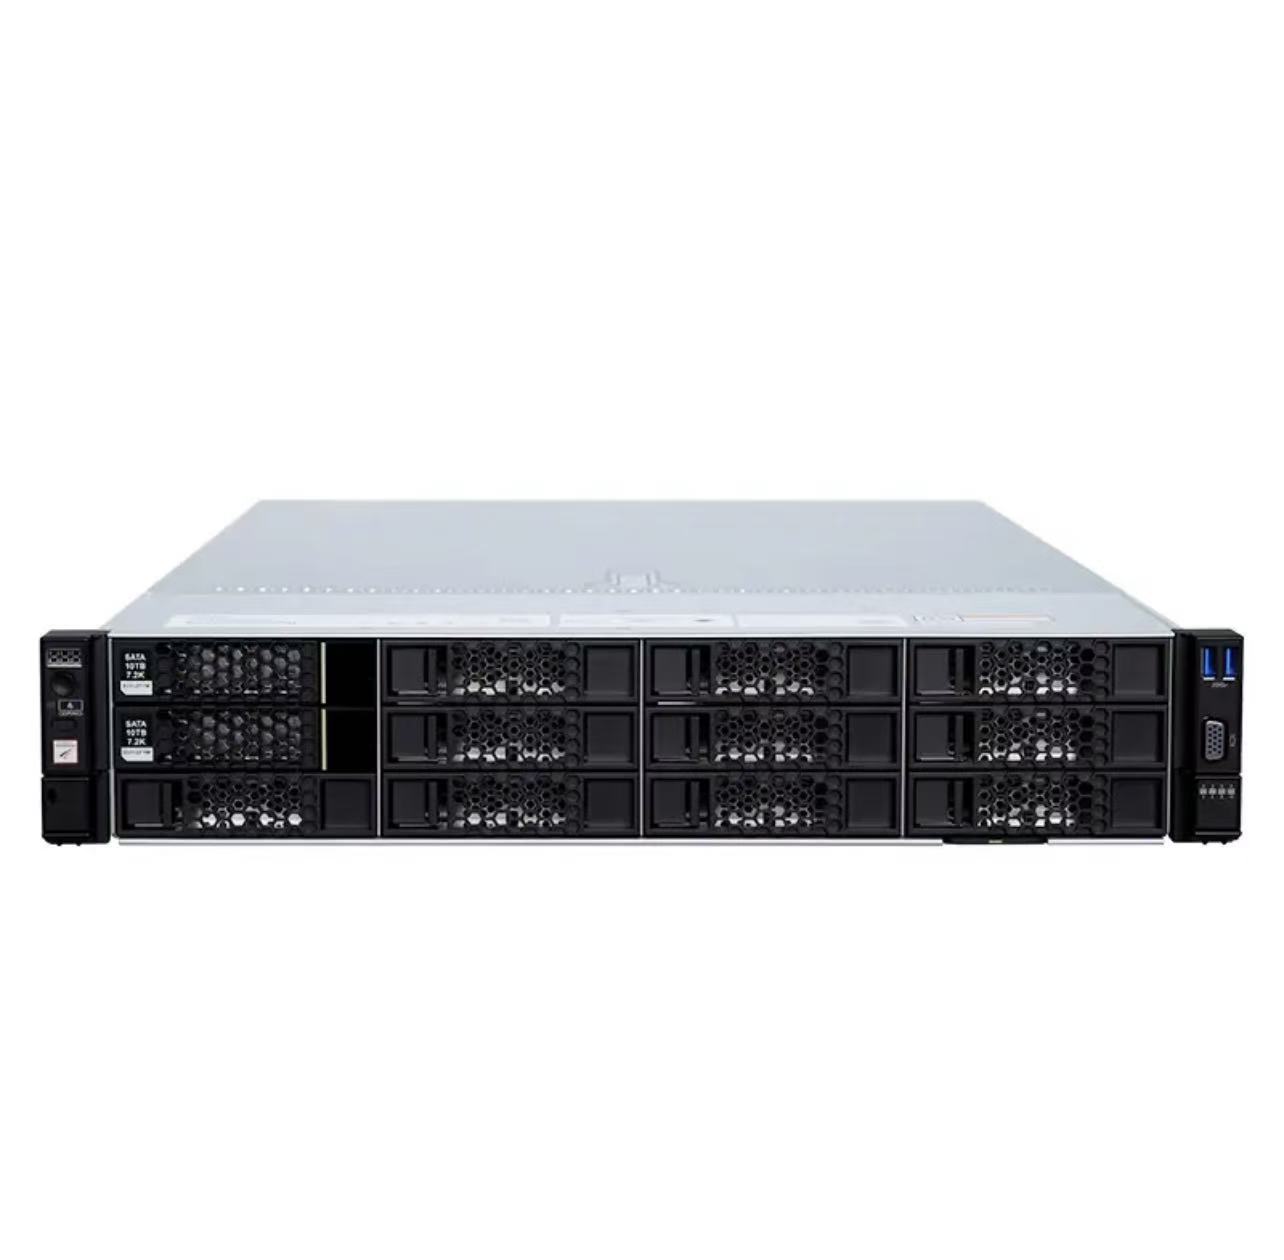
| Atlas 650 服务器 | 昇腾950PR | P 侧(预填充 / 推荐推理) |
| Atlas 750 服务器 | 昇腾950PR | P 侧(可插 1–8 张 Atlas 150 标卡) |
| Atlas 350 加速卡 | 昇腾950PR | P 侧加卡,已有服务器扩容用 |
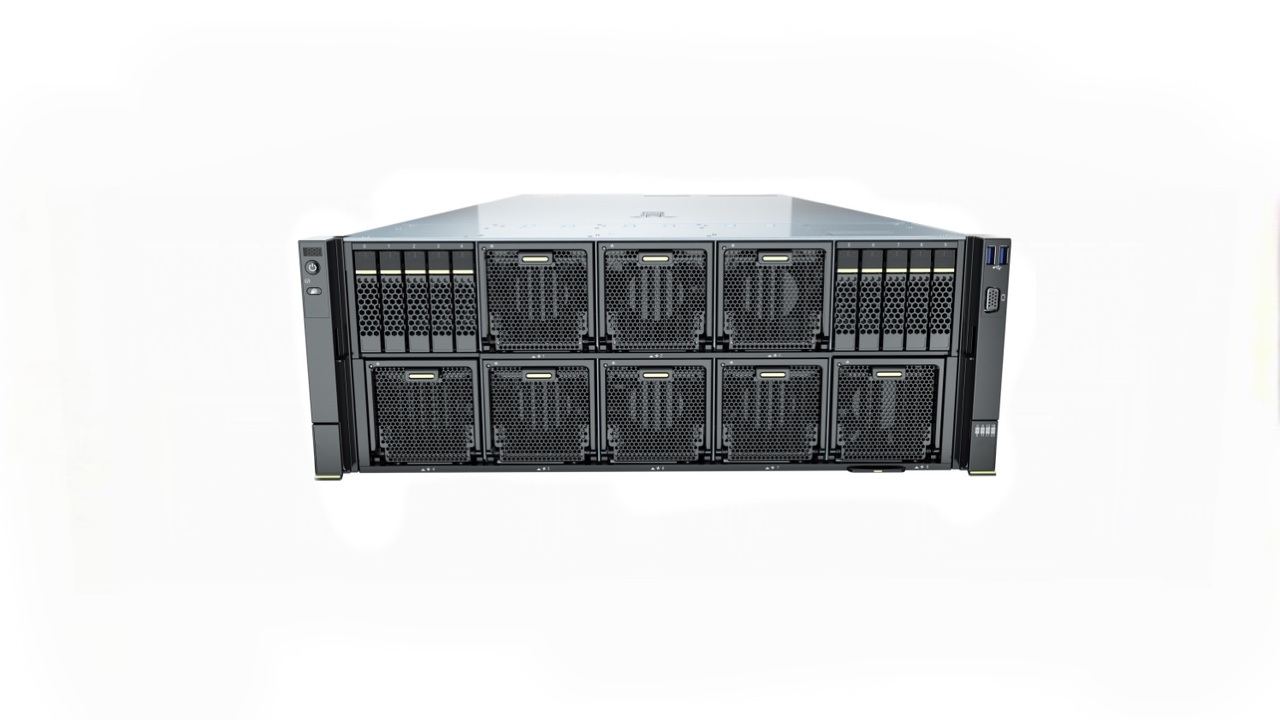
| Atlas 650E 服务器 | 昇腾950DT | D 侧(解码)+ 训练/微调 |
| Atlas 850E 风冷超节点 | 昇腾950DT | D 侧大规模 + 后训练 |
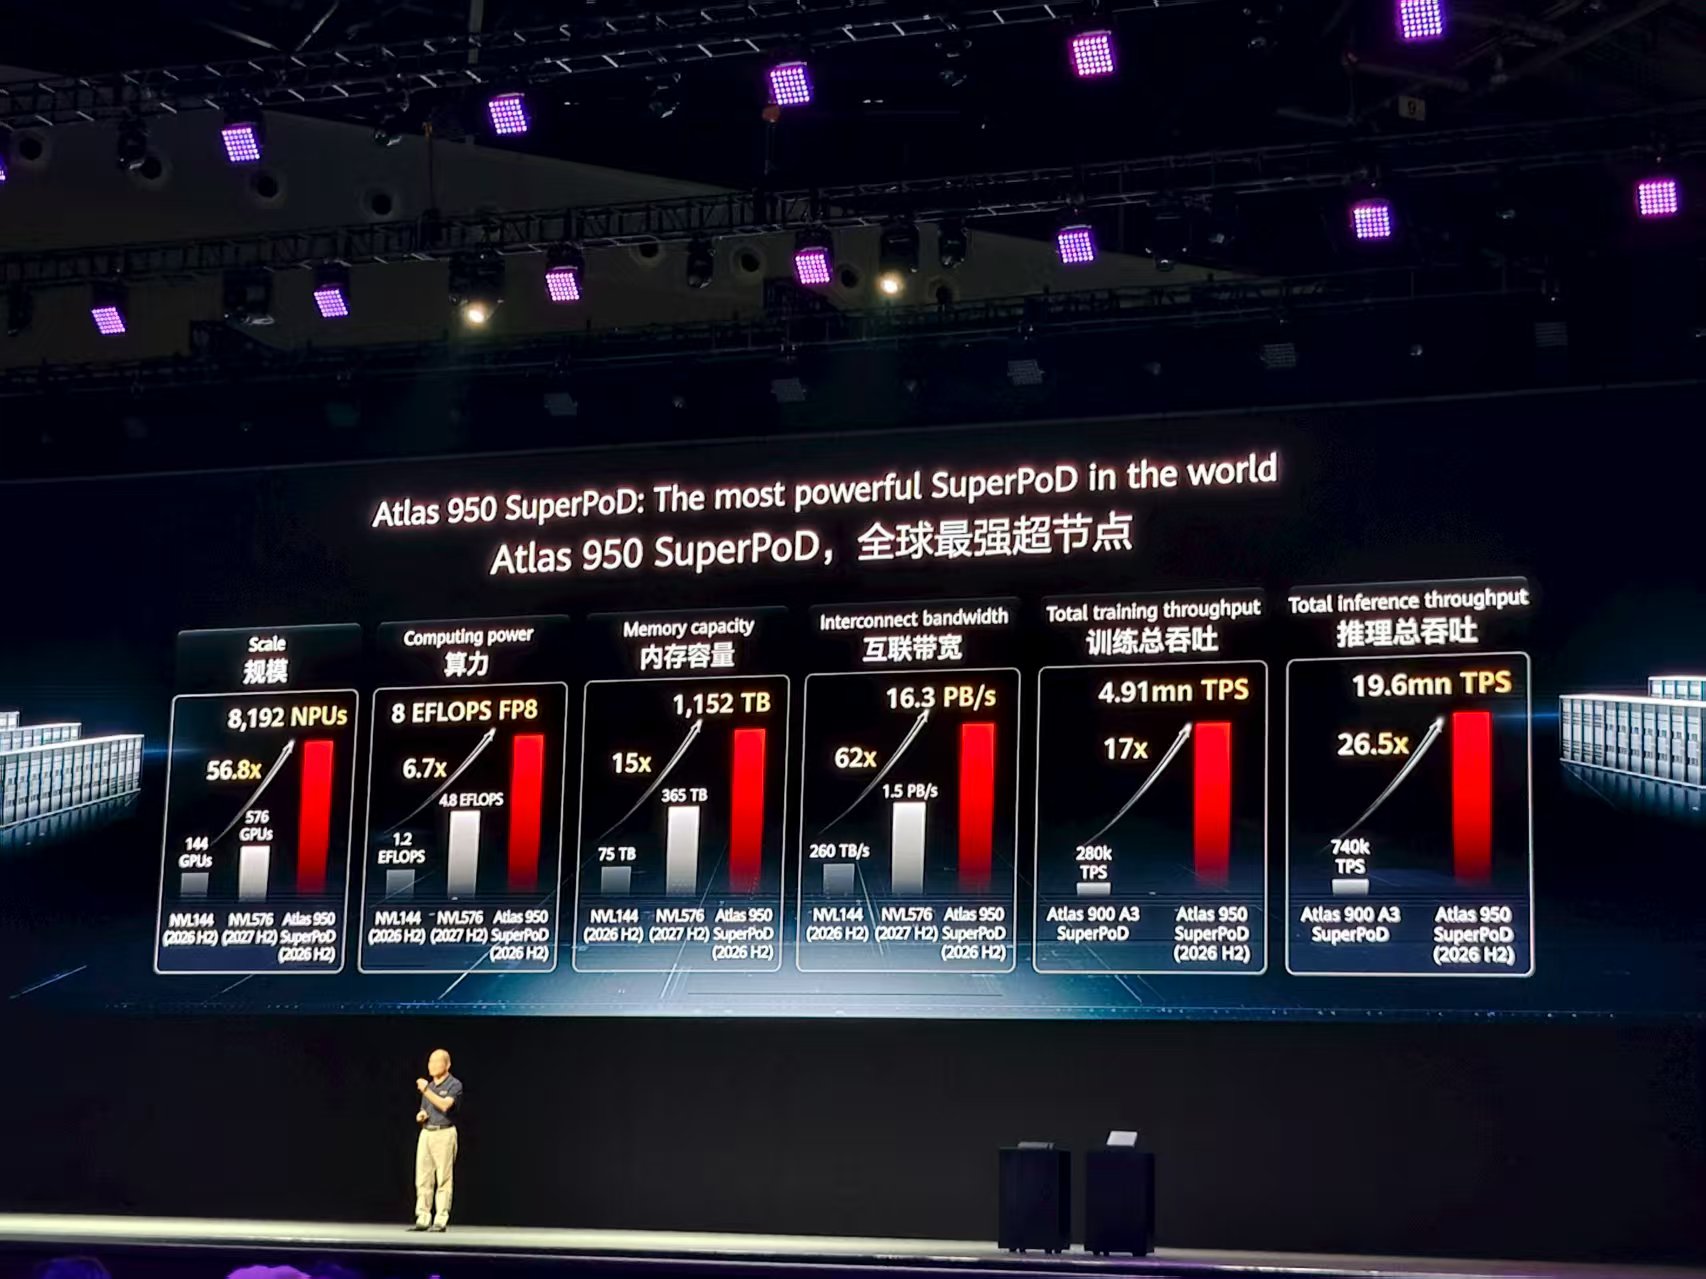
| Atlas 950 SuperPoD 液冷超节点 | 昇腾950DT | 训练与高并发推理一体,最大支持 1024 颗昇腾950DT |
按官方公开规格,Atlas 650E 单机支持 8 颗 NPU,最大 12.4 PFLOPS mxFP4 算力、最大 4.0 TB/s 读写带宽,采用 14U 风冷机架形态。这意味着它在 D 侧是"带宽足够、风冷可上架"的一档——对存量机房友好。
所以配比的落地问题其实是两个:P 侧用几台 650/750,D 侧用几台 650E(或上不上超节点)。 前者决定预填充吞吐,后者决定解码时延和并发上限。
七、三种典型配错,以及各自的代价
配比失衡不会立刻报错,只会表现为"钱花了但跑不满"。三种最常见的:
只买 DT,不配 PR。 想法通常是"DT 更强,买强的不会错"。问题在于 DT 的 4TB/s 带宽是为访存密集的 Decode 和训练准备的,用它跑 Prefill 属于用高带宽资源做计算密集的活——单位算力的成本上去了,预填充吞吐却未必最优。 更麻烦的是训练任务和推理预填充会互相抢机器。
只买 PR,等着跑训练。 相反的错法。950PR 的片上内存是 128/112GB 档、带宽 1.6/1.4 TB/s,做 Prefill 和推荐推理很合适,但训练和长上下文 Decode 需要的是带宽——这一档的带宽是 950DT 的 35% 到 40%(按 1.4 对 4 计算),硬上会先撞带宽墙。
按固定比例一次性配死。 最常见也最贵的一种。业务还没跑起来就把 P/D 比例写进采购清单,等真实负载上来发现比例不对,要么 P 侧排队、要么 D 侧闲置,而调整意味着重新走采购流程。配比是运行期参数,不是采购期常量。
八、关于 PR / DT 与配比,几个常见问题
昇腾950PR 和 950DT 哪个贵?
两者是不同的规格档,价格不能直接比。更实际的是比"单位有效算力成本"——而有效算力取决于你的负载落在哪个阶段。把任务和芯片对上之后,价格比较才有意义。具体报价随配置与货期变化,以正式报价为准。
昇腾950 是推理卡吗?还是训练卡?
两者都是。950PR 面向预填充与推荐场景,950DT 覆盖解码与训练全流程。"推理卡/训练卡"这个二分法在这代产品上已经不够用了,按阶段划分更准确。
不想搞 PD 分离这套,能简单点吗?
能。入门规模用 PD 混部即可,昇腾官方也提供 PD 混部的部署路径。只有当 decode 时延成为硬约束、或规模上来之后,PD 分离的收益才明显。先按能跑起来的方式部署,再按瓶颈决定要不要分离,比一开始就上复杂架构更省事。
配比能后期调吗?
可以,而且应该调。昇腾 MindIE 的 PD 配比调优就是为此设计的。但能不能调取决于你采购时有没有留出余地——比如机型是否支持灵活的实例划分、扩容路径是否清晰。这件事在选型阶段就要问清楚。
只有几十卡,需要按超节点的思路配吗?
不需要。几十卡规模、标准风冷机房、短期无扩容计划的场景,按超节点标准做前置改造既不必要也不经济。用 8 卡整机或单双机形态把比例调对,比堆规模更划算。
配比是输出,不是输入
回到最初的问题:昇腾950PR 和 950DT 怎么配?
答案是一条三段式的推理链:先看阶段(Prefill 还是 Decode 是瓶颈)→ 再定模式(PD 混部还是 PD 分离)→ 最后落机型(P 侧用不带 E 的 650/750,D 侧用带 E 的 650E 或超节点)。 配比是这条链的输出,不是输入。
配比方案定下来之后,货和价才是下一步。数聚红芯是华为官方认证的昇腾 APN 合作伙伴,昇腾全系模组与整机 910B / 910C / 950PR / 950DT 都有现货库存,也接受预订下单,一手资源与价格。如果你已经在做方案,可以把模型规模、提示长度分布、并发目标和时延要求发给我们,我们先帮你把 P/D 两侧的机型组合拉出来,再谈比例怎么调。
📞 咨询热线:400-869-9865 | 联系我们,提交你的项目条件
相关阅读