




大模型私有化部署的热度涨了快两年,不少政企单位的 IT 负责人都私下算过账:搭一套能跑百亿级参数模型的集群,硬件成本动辄上百万,还要专门拉团队做运维,更别说金融、政务这类对数据安全有硬性要求的行业,压根不能把核心数据放到公有云里。信创合规的大背景下,找一款性能够用、生态适配、安全可控的国产算力服务器,成了很多人当下的核心诉求。
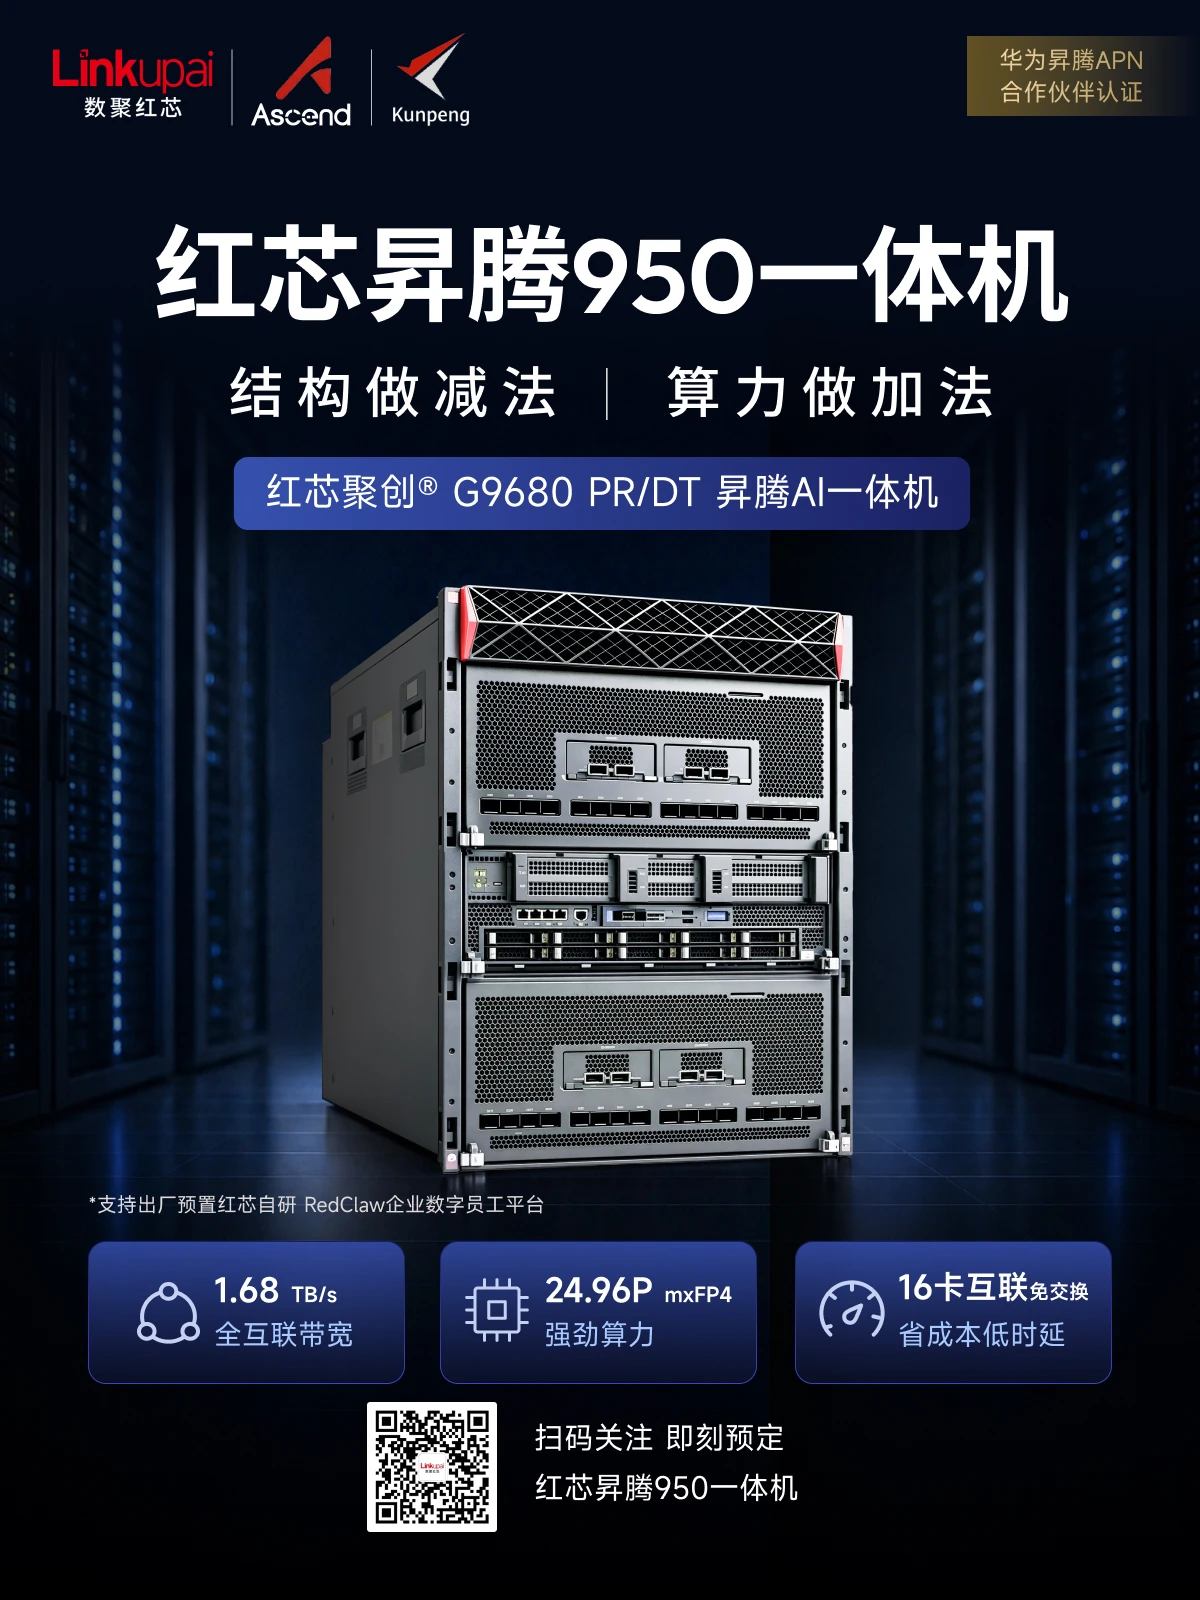
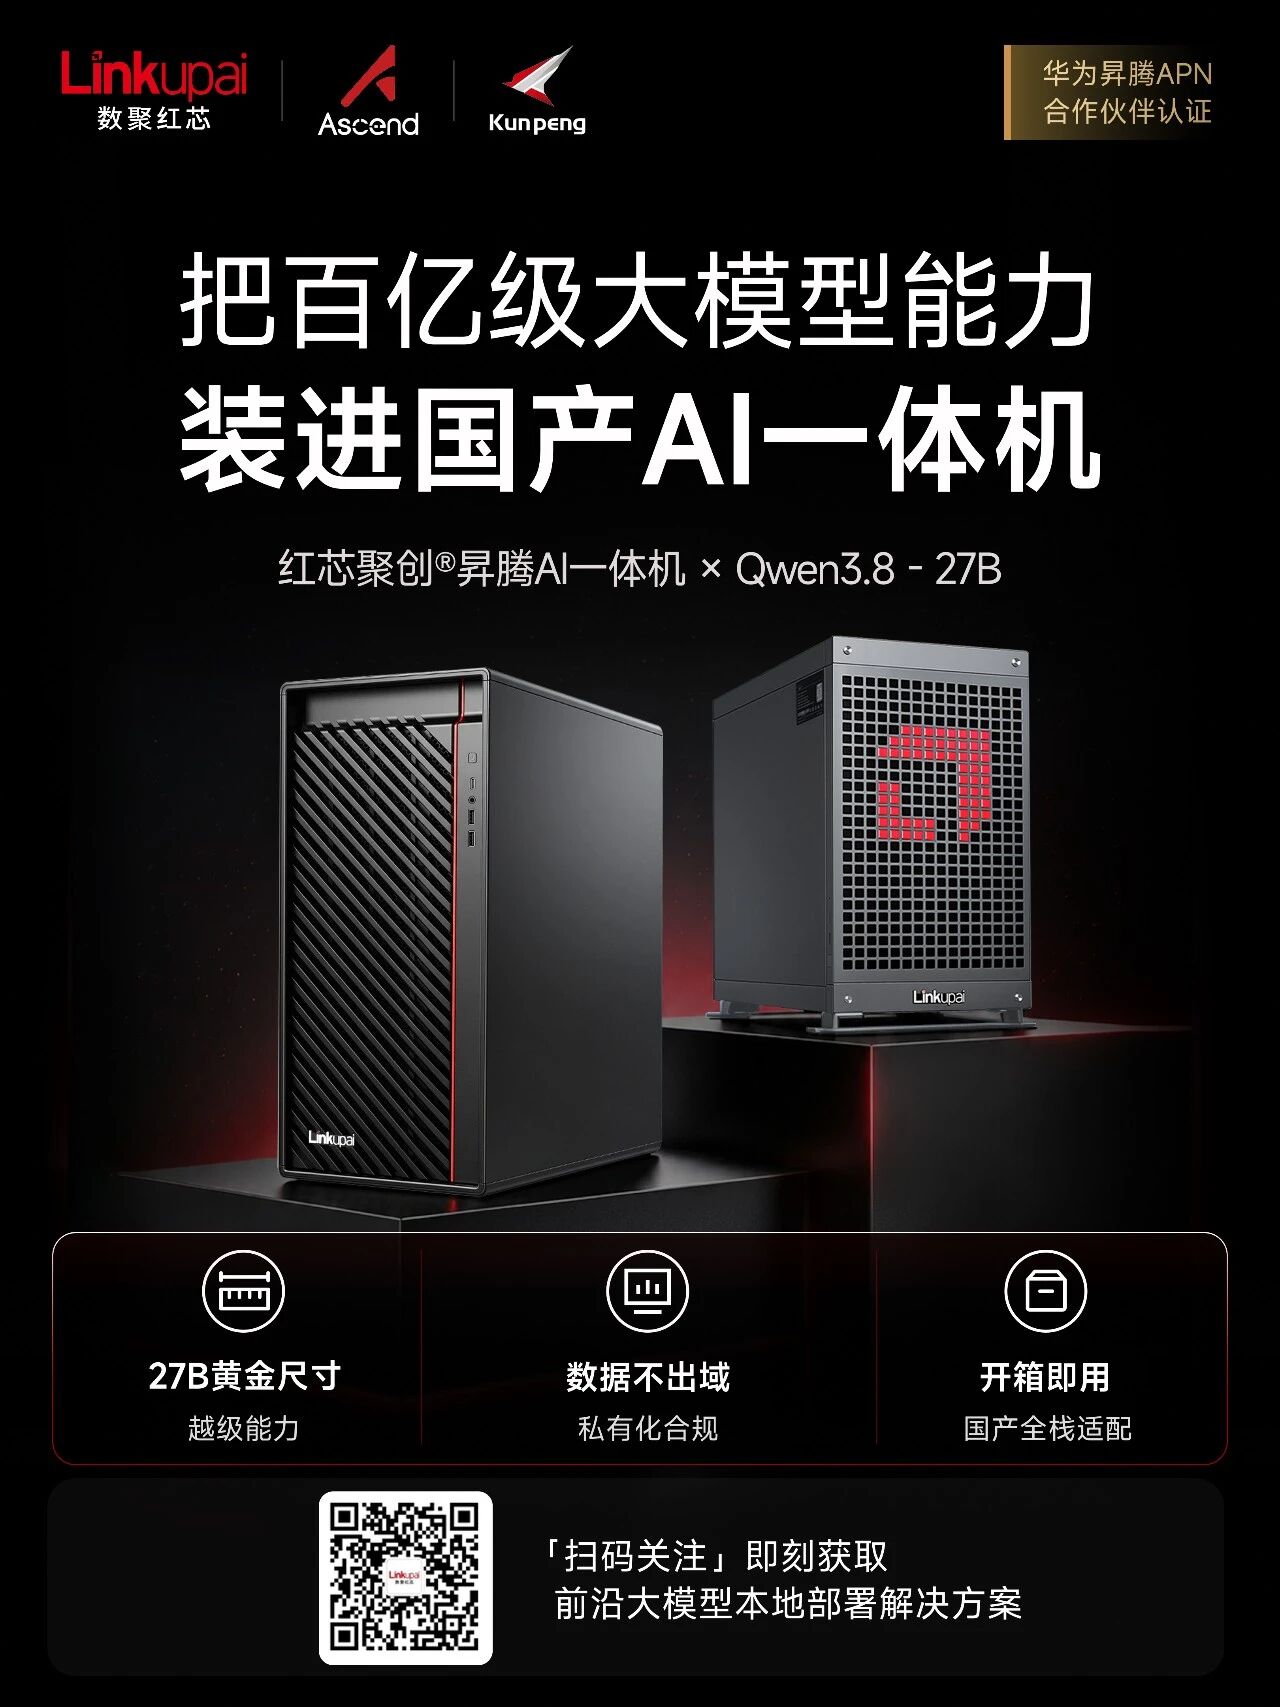
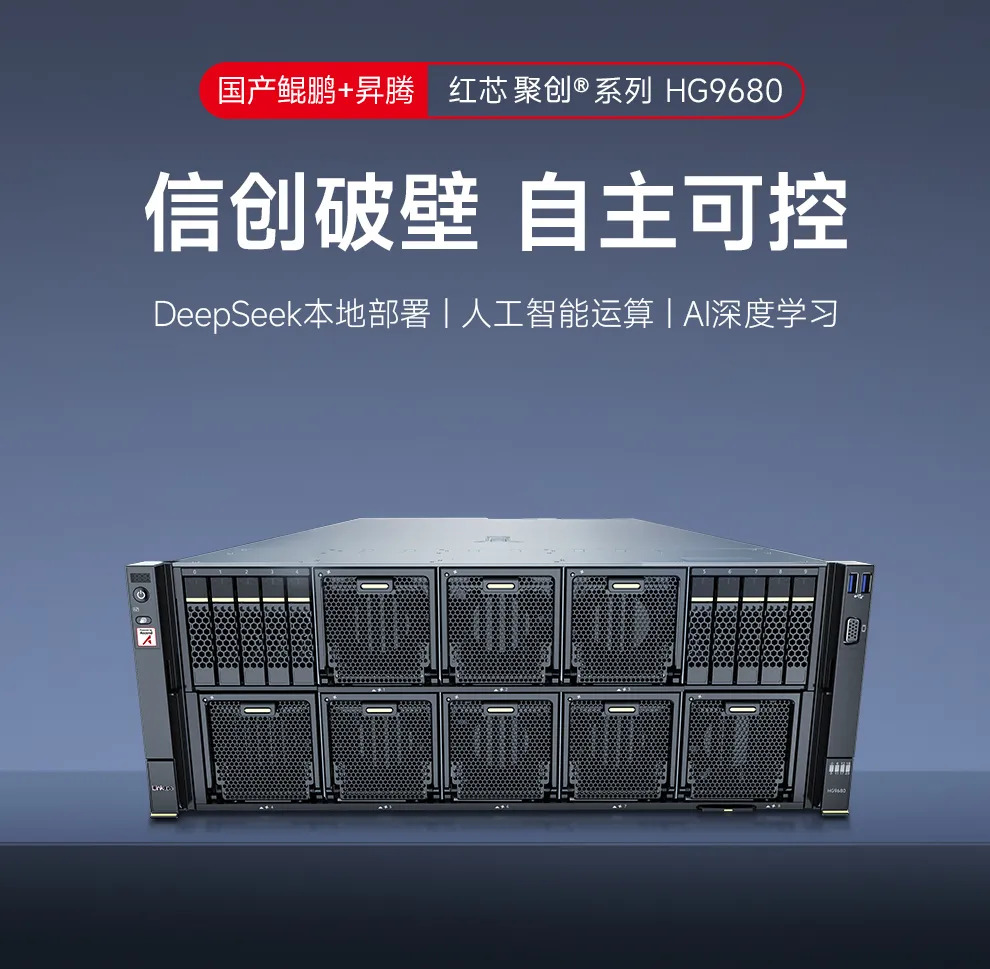
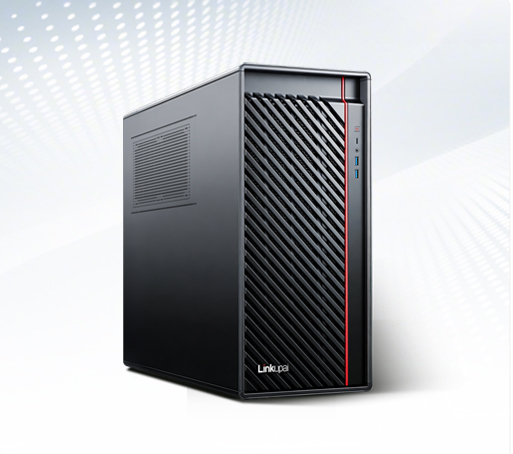
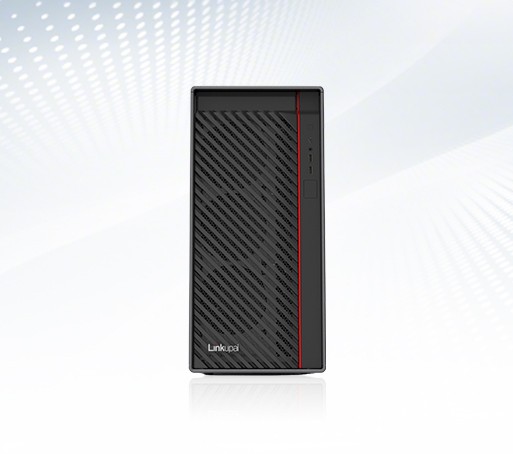
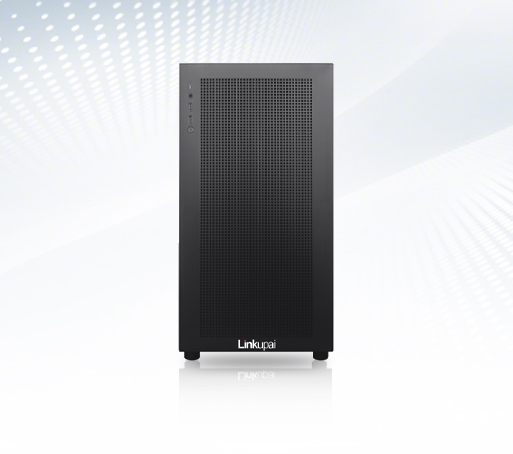
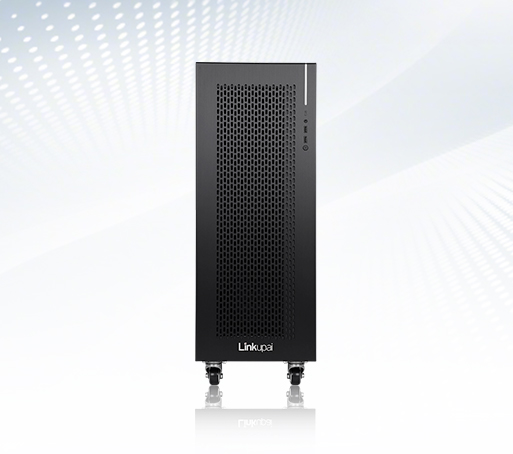
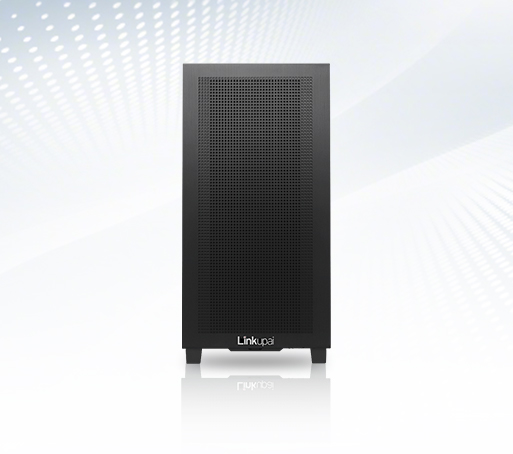
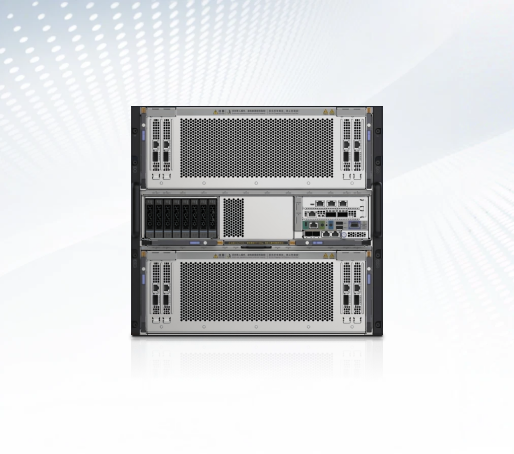
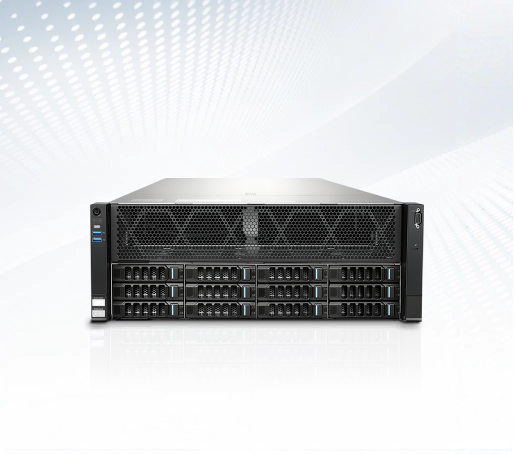
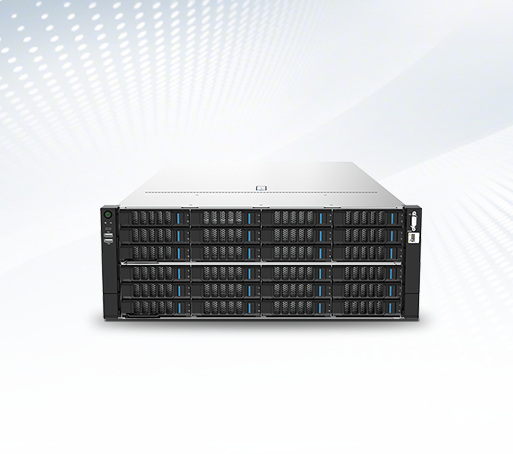
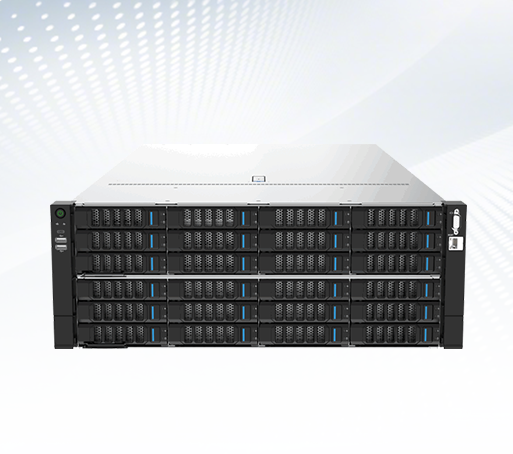
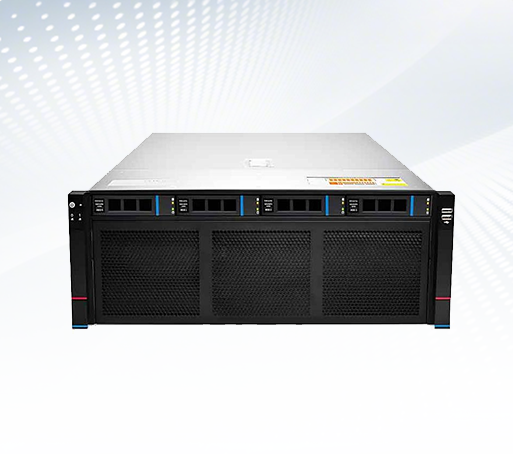
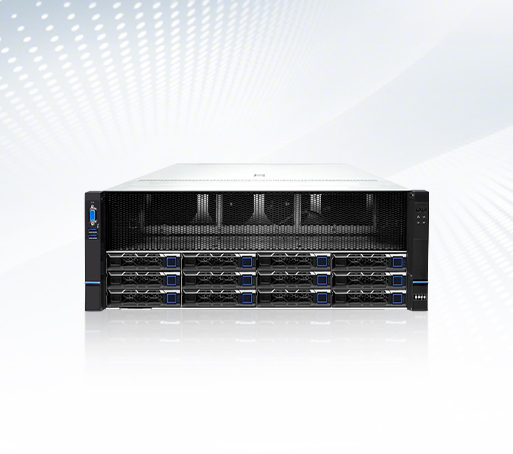
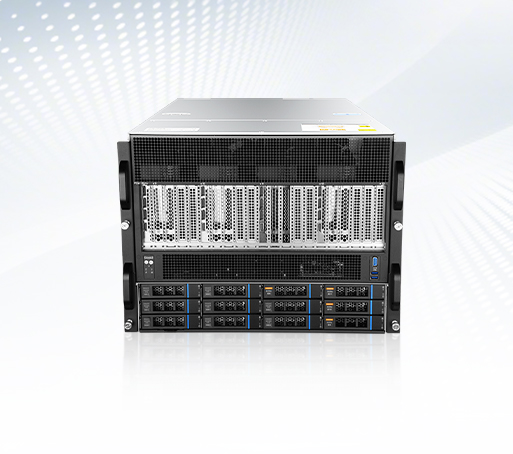
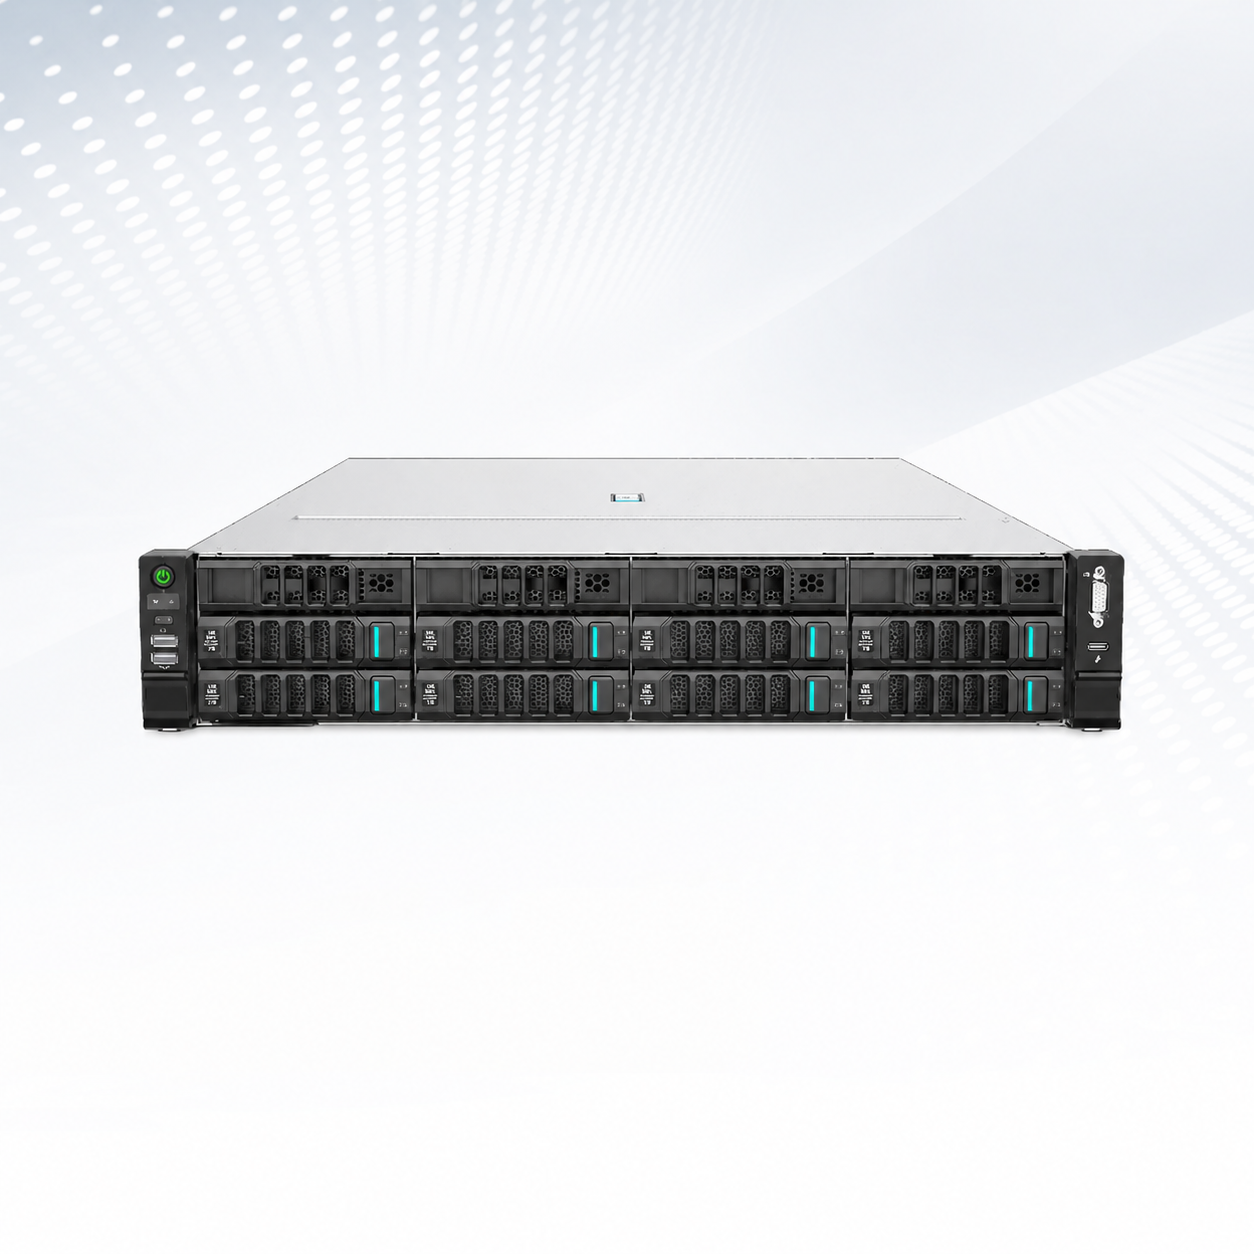
最近数聚红芯与华为深度合作推出的红芯聚创™ HG9680 昇腾 AI 一体机,给出了一个不一样的思路:不用搭复杂的多节点集群,单台国产算力服务器就能完成 DeepSeek V4 系列大模型的私有化部署,把落地门槛拉低了不少。
信创提速,国产算力服务器进入落地攻坚期
过去几年,信创产业的推进节奏一直在加快,从办公终端到业务系统,再到底层算力设施,国产化替代已经从 “可选项” 变成了很多行业的 “必选项”。政务、金融、科研等领域的核心业务,对数据自主可控的要求极高,传统依赖进口芯片的服务器方案,不仅存在供应链波动的风险,也很难满足数据不出域、全链路可管可控的合规要求。
早期的国产算力服务器,常被贴上 “性能不足”“生态差” 的标签,很多单位只敢在非核心场景试水。随着国产芯片架构的迭代和软件生态的完善,这种情况正在发生变化。现在市面上的国产算力服务器,已经能覆盖 AI 推理、模型训练、大数据计算、量化回测等多种核心场景,性能表现足以匹配多数企业的业务需求,再加上自主可控的安全属性,逐渐成了数字化转型里的主流选择。
从政策端来看,党政机关、关键信息基础设施领域的信创替代要求逐步明确,带动了国产算力服务器的需求释放。很多单位不再满足于 “单纯替换硬件”,而是希望借着国产化的契机,同步完成 AI 能力的升级,用新的算力底座支撑智能审核、智能客服、风险研判等新业务。这种 “替代 + 升级” 的双重需求,也对国产算力产品的综合能力提出了更高要求。
单台即可部署大模型,这款国产算力服务器的硬实力拆解
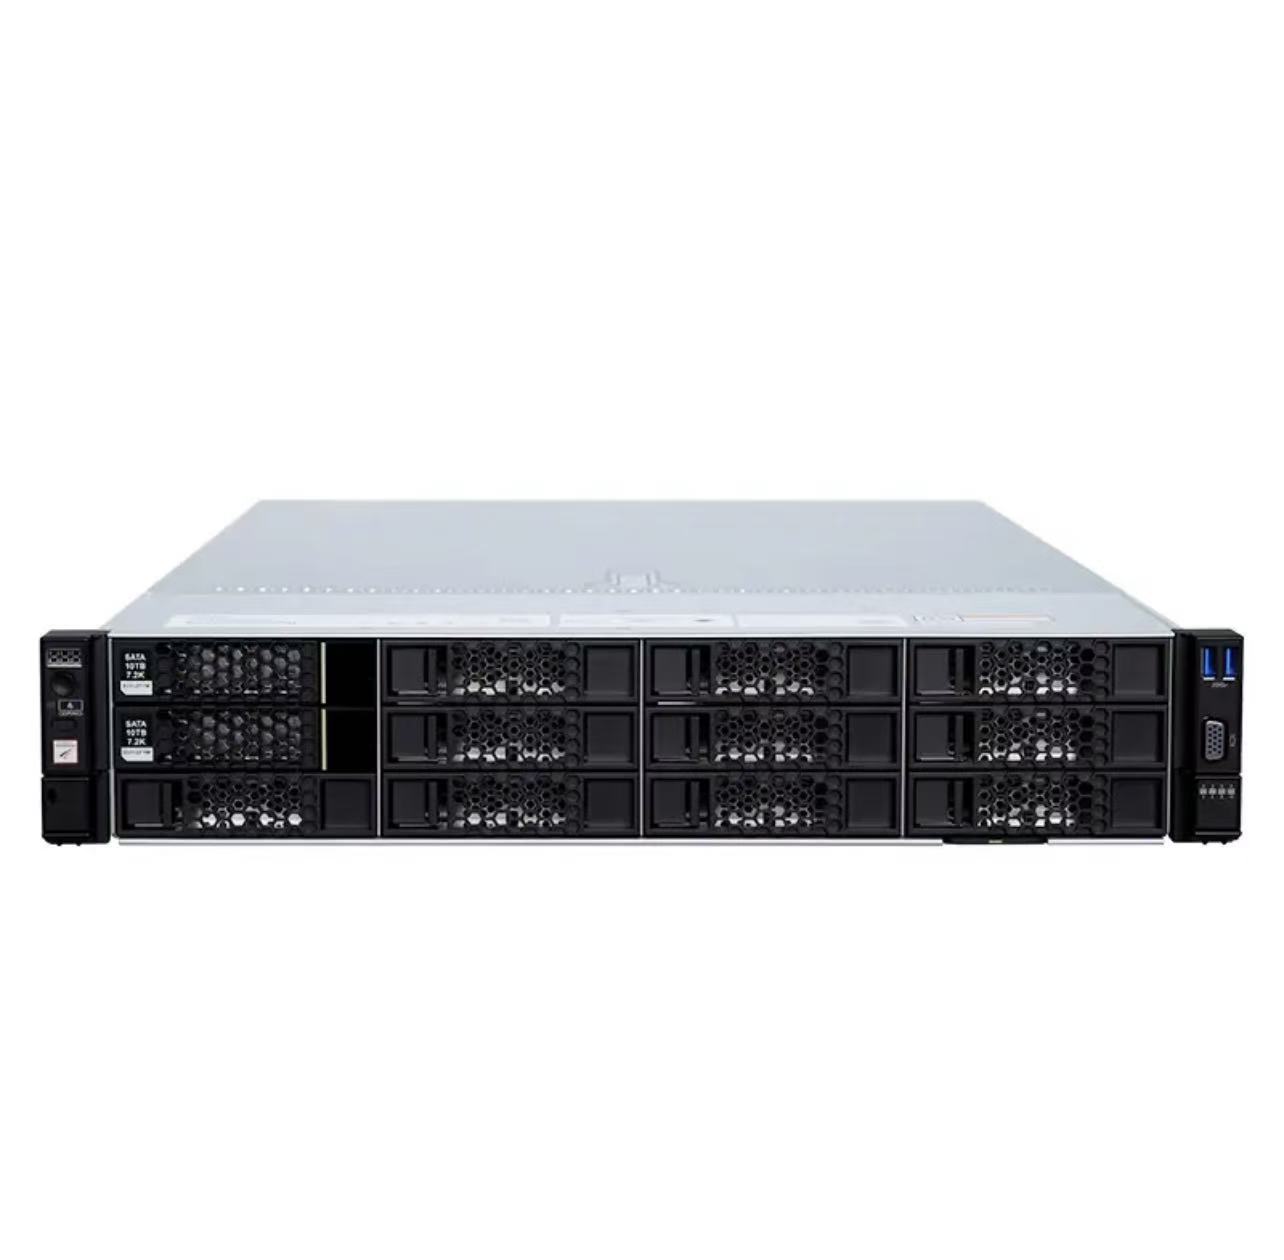
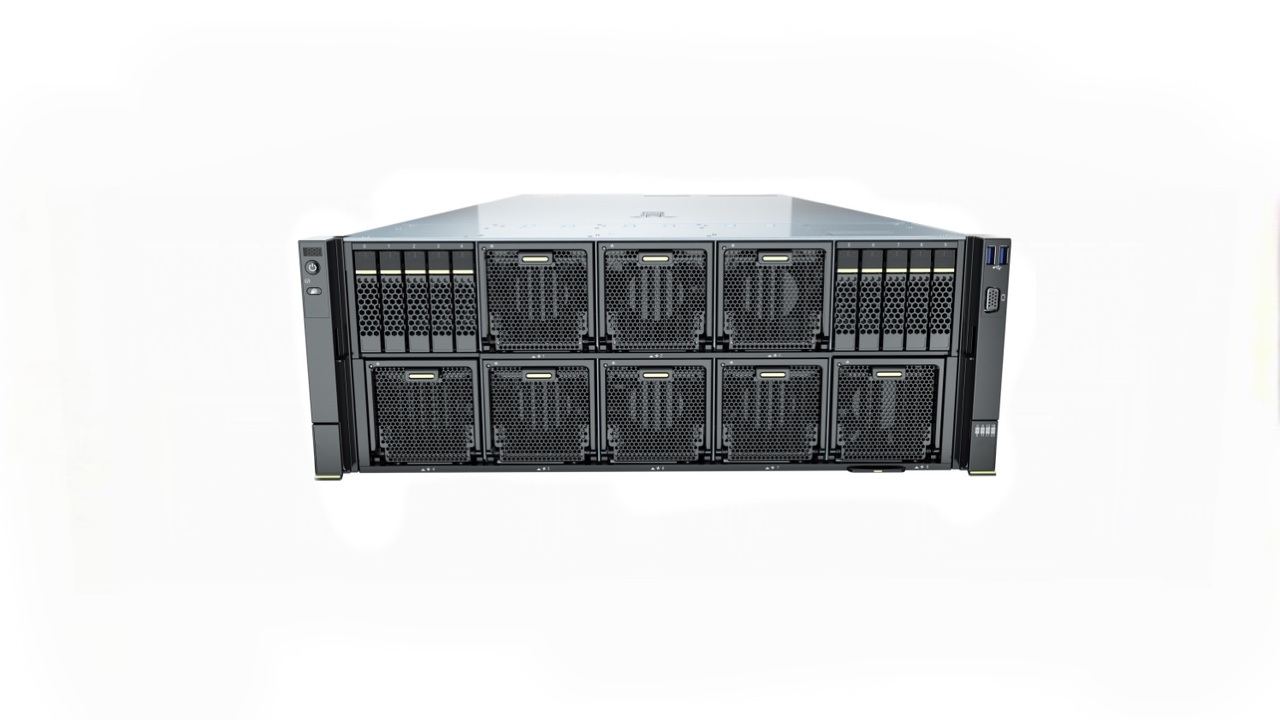
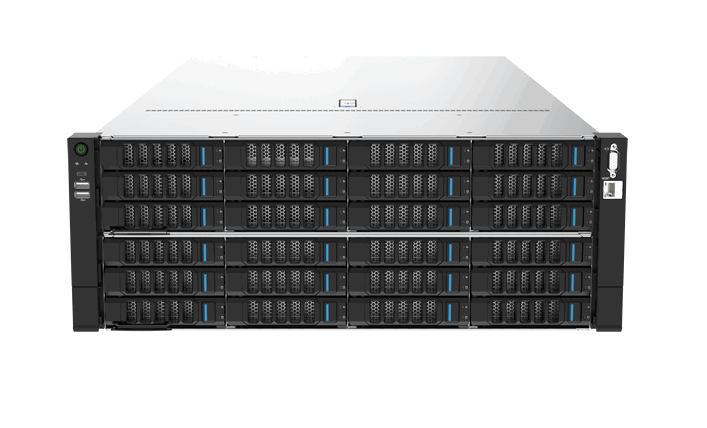
红芯聚创™ HG9680 昇腾 AI 一体机,是数聚红芯基于华为昇腾算力打造的一款国产算力服务器,专门针对企业级大模型私有化场景做了优化。硬件配置上,这款一体机搭载 8 卡昇腾 910B NPU 模组,配备总计 512GB 高速互联的 HBM2e 显存,算力池的规格足以承载大参数模型的运行需求。
以 DeepSeek-V4-Flash 模型为例,这款采用混合专家架构的大模型总参数量达 2840 亿,单次推理仅激活约 130 亿参数,在 w8a8 量化精度下,模型权重的显存占用约 280GB。单台 HG9680 的显存容量不仅能完整承载模型权重,还能预留充足空间支撑百万 Token 上下文的 KV 缓存,也就是说,企业不用搭建复杂的多节点分布式集群,单台设备就能跑起这套大模型。
这种单节点就能落地的模式,最直观的优势是拉低了成本和时间门槛。对比传统多节点集群方案,硬件采购的投入有明显降低,部署周期也能从数周压缩到 3 天以内。企业不用专门组建 AI 运维团队,就能完成模型的上线调试,对于没有太多技术储备的传统政企单位来说,友好度很高。
长文本处理能力也是这款产品的亮点之一。依托充足的显存空间,它支持一次性处理约 75 万字的超长文本,像企业内部的合同库、政策文档、代码仓库这类内容,可以直接做端到端的分析,不用提前做 RAG 分片处理,简化了应用落地的流程。同时全链路采用国产化技术栈,从底层处理器到算力芯片再到大模型,都不依赖海外技术生态,能很好地满足数据不出域的合规要求。
多场景落地验证,性能与稳定性经住业务考验
一款国产算力服务器好不好,最终要落到实际业务场景里看效果。目前在政务、涉密单位、金融等多个领域,已经有不少单位落地了这类昇腾算力方案,实际表现超出了很多人的预期。
政务服务场景里,某市政数局一直在推进 “数字政府” 建设,过去用传统 CPU 服务器做政务材料的 AI 预审,高峰期一份材料的审核要等 3 秒以上,群众办事排队久,满意度上不去。换成国产信创 GPU 服务器之后,8 颗国产算力芯片协同推理,搭配大内存和高速存储阵列,单份材料的 AI 审核响应压缩到 0.8 秒,预审效率提升明显。这套方案还做了全栈信创适配,从 CPU 到 GPU 再到操作系统都是国产化路线,政务数据全程在本地处理,不会流出政务内网,全年系统可用性保持在较高水平,高峰期也能稳定承载数千份材料的并行审核需求。
涉密单位的场景对安全和稳定性的要求更严苛。某国家涉密单位此前的算力设备不仅不符合信创合规要求,还存在散热差、噪音大的问题,高负载运行时容易降频宕机,影响办公环境和业务连续性。引入昇腾 AI 一体机之后,核心软硬件全部采用国产化方案,满足涉密场景对自主可控的严格要求;同时搭配自研液冷散热技术,设备运行噪音控制在 50 分贝以内,GPU 长时间高负载运行也不会出现降频,能耗也有明显下降,兼顾了性能、安全和办公环境适配性。
金融量化领域对算力的稳定性和延迟要求极高。上海某量化科技企业过去的算力架构比较分散,多市场并行回测的时候资源调度效率不高,单次策略回测要花很长时间,跟不上策略迭代的节奏。通过国产算力服务器搭建异构 HPC 集群之后,算力资源统一池化调度,资源利用率有显著提升,策略回测的速度明显加快,交易执行的延迟也控制在理想范围内。集群还做了硬件级冗余设计,关键部件都有备份,避免单点故障影响交易连续性,满足金融行业 7*24 小时不间断运行的要求。
破解兼容焦虑,全栈生态适配降低迁移门槛
很多企业对国产算力服务器持观望态度,核心顾虑之一就是软件兼容性。过去换国产算力平台,往往要花几个月做模型适配、代码改造,人力成本和时间成本都很高,很多单位因此迟迟不敢推进替代。
针对这个痛点,这款昇腾 AI 一体机做了全栈式的软件适配优化。对于 PyTorch、TensorFlow 这类行业通用的深度学习框架,产品都做了深度适配,企业原来基于这些框架开发的算法模型,不用做大规模的代码重构,就能迁移到平台上运行,大幅降低了迁移成本。同时它还适配了多种国产化推理框架,能和政务、金融领域的现有业务系统做无缝对接。
从底层硬件到上层应用的全国产链路,是这款国产算力服务器的核心优势之一。CPU 层面支持鲲鹏、海光等主流国产处理器,算力芯片覆盖昇腾、MR-V100 等国产 NPU 路线,操作系统兼容 OpenEuler、银河麒麟、统信 UOS 等国产系统,从数据输入、计算处理到结果输出,全流程都在国产化技术栈内完成,不存在海外技术 “卡脖子” 的风险。这种全栈自主可控的架构,也能更好地满足等级保护、数据不出域等合规要求,适配政务、金融、涉密单位等强监管场景的需求。
除此之外,数聚红芯还提供从硬件选型、集群搭建到应用开发的全流程服务,企业不用单独对接多家厂商,就能完成整套算力方案的落地。对于很多缺乏 AI 技术团队的传统企业来说,这种一站式的服务模式,能减少很多沟通和试错成本。
从 “能用” 到 “好用”,国产算力重构替代价值
很多人对国产替代的印象还停留在 “降本替代” 层面,觉得就是用更便宜的方案替换进口产品,性能上总要打些折扣。但现在的国产算力服务器,早已走出了 “凑合用” 的阶段,开始在很多场景里实现适配业务需求的定制化优化。
数聚红芯与华为深度合作的这款昇腾 AI 一体机,核心逻辑不是做 “硬件的简单国产化拼凑”,而是从业务场景出发,把算力、软件、散热、安全做一体化的优化。对于有信创需求的政企单位来说,它既能满足合规层面的硬性要求,又能提供足够的算力支撑 AI 大模型、智能审核、量化计算等核心业务,不用再在 “安全” 和 “性能” 之间做取舍。
除了硬件本身,配套的服务体系也是落地的关键。数聚红芯有覆盖全国的服务网点,提供 7*24 小时的技术响应,从前期的方案设计、部署实施,到后期的运维巡检、升级扩容,能提供全生命周期的技术支持。对于没有专业算力运维团队的单位来说,这种一站式的服务能减少很多后顾之忧。
信创产业的发展从来不是一蹴而就的,从硬件可用到生态成熟,再到场景深化,需要产业链上下游的共同推进。国产算力服务器作为数字基建的核心部件,正在一步步从边缘走向核心,支撑起更多行业的数字化转型。
对于正在考虑大模型私有化部署、信创算力替代的政企单位来说,选一款经过多场景验证、生态适配完善、服务体系健全的国产算力服务器,不仅能解决当下的合规和算力需求,也能为未来几年的 AI 应用落地打好底层基础。随着技术的持续迭代,国产算力的应用边界还会不断拓宽,给更多行业的数字化升级带来新的可能。