









Qwen3.8-27B 部署配置的答案,官方文档给得很直接:用 w8a8-310p 量化权重,1 张 Atlas 300I DUO 就能起服务。但要让它当生产系统用,决定配置的不是"能不能跑起来",而是三件事——上下文窗口开多大、要挡住多少路并发、思考模式开不开。这三件事每变一档,卡数就可能翻一倍。
2026 年 8 月 14 日,阿里千问团队开源了 Qwen3.8-27B,Apache 2.0 协议。它是个 27B 稠密模型(不是 MoE),64 层里只有 16 层跑完整的门控注意力,另外 48 层是 Gated DeltaNet 线性注意力,循环状态大小恒定。原生上下文 262,144 token,用 YaRN 可以扩到 1,000,000,并且自带视觉编码器,能读图像和视频。
对准备私有化的企业来说,这些参数的意义是同一个:权重文件不算大,但"生产可用"这四个字的成本,藏在参数之外。
能跑起来和能扛得住,是两道不同的题
搜"Qwen3.8-27B 部署配置",排在前面的结果里,超过一半在回答"我的电脑/我的 Mac 能不能跑"。那是个人验证的题。企业要买的是一台要值班、要担责的机器,判断依据完全不同。
| 判据 | 个人验证场景 | 企业生产场景 |
|---|---|---|
| 并发形态 | 一个人、一次一问 | 同时在线几十到上百路,排队时间要可预期 |
| 上下文长度 | 短对话,几千 token | 一次读完整本合同、整本标书,动辄几万到十几万 token |
| 可用性要求 | 崩了重启就好 | 7×24 值班,出问题要有人能定位到具体版本和参数 |
| 责任边界 | 自己承担 | 需要交付方对精度、时延、故障响应负责 |
| 成本口径 | 一次性买卡 | 卡钱 + 电费 + 机柜空间 + 三年运维 |
| 量化取舍 | 能跑就行,4-bit 也接受 | 精度必须可复核,量化方案要能对标原始权重 |
把左边那一列的经验直接搬进采购决策,最常见的后果是:机器买回来了,单机测速很好看,上线第一个月就 OOM。
27B 的显存账单:权重只是一半
先看权重本身。Qwen3.8-27B 官方在 ModelScope 和 Hugging Face 上提供 BF16 与 FP8 两种权重,昇腾侧另有三个厂商量化版本。这些都是可以按字节核对的文件体积,不是估算值。
| 权重版本 | 发布方 | 文件体积 | 说明 |
|---|---|---|---|
| BF16 | 千问官方 | 51.77 GiB | 全精度,18 个分片 |
| FP8 | 千问官方 | 28.75 GiB | 分块 128 的细粒度 fp8,视觉塔不做量化 |
| W8A8 | 昇腾(Eco-Tech) | 29.94 GiB | 权重与激活值都压到 8-bit |
| W8A8-MXFP8 | 昇腾(Eco-Tech) | 34.82 GiB | 走 MXFP8 算力 |
| W8A8-310P | 昇腾(Eco-Tech) | 33.94 GiB | 专供 Atlas 300I DUO |
注意 FP8 那一行:量化时整个视觉塔被排除在外(配置里 modules_to_not_convert 明确列出了所有 visual.blocks.* 张量)。也就是说,如果你的业务要用它读图纸、读报表截图,视觉部分的显存开销必须单独算,不能按"权重砍了一半"来推。
另一半账单是 KV Cache——模型在读上下文时存下来的中间状态。这里 Qwen3.8-27B 有个容易被忽略的结构优势:它的 64 层里只有 16 层是完整注意力,另外 48 层用的是循环状态恒定的线性注意力,所以 KV Cache 的增长速度远低于传统稠密模型。
第三方在单张 24GB 显卡上的实测把这个差距量出来了:这套混合架构每 token 的 KV 开销约 28,672 字节,而如果是一个同样 27B 的传统稠密模型,大约需要 90,000 字节——相差三倍以上。这个数字直接决定你能把上下文开多长:同一台 24GB 机器,262,144 的完整原生窗口需要约 7.0 GiB 的 KV 空间,而实际能腾出来的只有 6.1 GiB,结果就是 OOM;降到 131,072 则能稳定跑起来,并留出约 1 GiB 余量。
打个比方:KV Cache 像会议室的椅子。混合架构把大部分椅子换成了可折叠的,同样一间房能坐更多人;但要开 26 万人的大会,房间还是不够。
昇腾官方给的四道硬件门槛
昇腾侧的部署依据是 vLLM-Ascend 的官方模型教程,文档标注基于 vLLM-Ascend 0.23.0 验证编写,该版本首次支持 Qwen3.8-27B。官方对每个权重版本都写明了最低硬件要求:
| 权重版本 | 官方验证的硬件要求 | 单卡显存 |
|---|---|---|
| Qwen3.8-27B(BF16) | 1 个 Ascend950DT 系列(96GB×8)节点,或 1 个 Ascend950PR 系列(128GB×8)节点,或 1 个 Atlas 800 A3(64GB×16)节点,或 1 个 Atlas 800 A2(64GB×8)节点 | 64~128GB |
| Qwen3.8-27B-w8a8 | 1 个 Ascend950PR 系列(128GB×8),或 Atlas 800 A3(64GB×16),或 Atlas 800 A2(64GB×8) | 64~128GB |
| Qwen3.8-27B-w8a8-mxfp8 | 1 个 Ascend950DT 系列(96GB×8),或 Ascend950PR 系列(128GB×8) | 96~128GB |
| Qwen3.8-27B-w8a8-310p | 1 张 Atlas 300I DUO | — |
这张表里最值得多看一眼的是最后一行。BF16 和 W8A8 都要求以"节点"为单位(8 卡或 16 卡起),只有专为 310P 出的量化版把门槛降到了一张卡——把显存和算力压进单机的功耗与散热包络里。
代价是精度。官方在 AISBench 的 gen 模式下测了 GPQA Diamond:BF16 版本 90.40,W8A8 是 89.90,W8A8-MXFP8 是 89.39。三个数字都高于千问官方模型卡上公布的 89.2,原因是测试框架不同——这两组数字不能混着用,跨环境比较没有意义,同环境内的相对差距才作数。
Atlas 300I DUO:一张卡起步,但三个开关必须改
如果走 310P 这条路线,官方给出的启动命令是这样的(MODEL_PATH 替换成 ModelScope 模型 ID 或本地目录):
export MODEL_PATH=Eco-Tech/Qwen3.8-27B-w8a8
vllm serve $MODEL_PATH \
  --host 127.0.0.1 --port 8000 \
  --tensor-parallel-size 4 \
  --served-model-name qwen3.8 \
  --max-num-seqs 128 \
  --max-model-len 16384 \
  --trust-remote-code \
  --gpu-memory-utilization 0.90 \
  --mamba-ssm-cache-dtype float16 \
  --dtype float16 \
  --speculative-config '{"method": "qwen3_5_mtp","num_speculative_tokens":1}' \
  --compilation-config '{"cudagraph_mode": "FULL_DECODE_ONLY", "cudagraph_capture_sizes": [2,16]}' \
  --additional-config '{"ascend_compilation_config": {"enable_npugraph_ex": false}}'复制
这段命令里有四处是硬约束,不是可调可不调:
--dtype float16 必须写死,因为 Atlas 300I DUO 只支持 FP16;--mamba-ssm-cache-dtype 同样只能取 float16。enable_npugraph_ex 必须关掉,该平台不支持这一特性。num_speculative_tokens 在 300I DUO 上官方建议设为 1,而非其他平台通用的 3——MTP 收益取决于接受率,套用别处的参数不会更快。另外要先卸载 triton-ascend 和 triton。
还有一条容易被漏掉的部署约束:单节点部署虽然把 Prefill 和 Decode 放在同一个节点内完成,但在 Atlas 300I DUO 上至少需要 2 个设备;并行方式目前只支持张量并行(TP),按可用设备选 TP=2 或 TP=4。
TP=2 和 TP=4 的差别不只是算力,而是能不能开长上下文。官方在推荐配置里写得很明确:TP=4 时 --max-model-len 可以支持 128k 和 256k 的长序列场景,并且要按需配置 --max-num-seqs——设得过高可能导致 OOM。
换句话说,"几张卡"这个问题的答案,最终由你要开的上下文长度倒推出来。
单卡、双卡、四卡:分界线落在哪里
把官方的并行建议和实际机型对上,选型路径其实很短。数聚红芯的信创产品线正好覆盖了这几个档位:
| 机型 | AI 加速卡 | 片上内存合计 | 对应官方并行档位 | 适合的场景 |
|---|---|---|---|---|
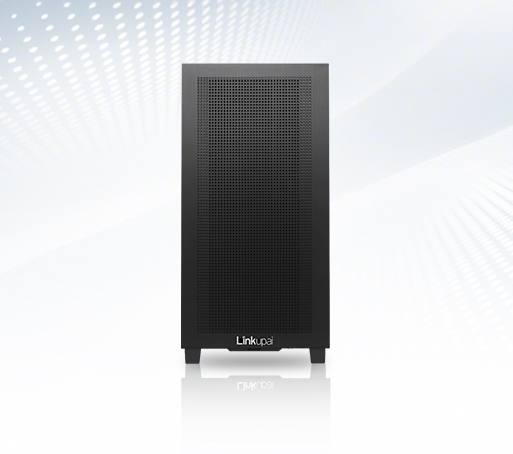
| HI5228 昇腾 AI 一体机 | Atlas 300I Duo 96G × 2 | 192GB | TP=2 | 单部门知识库、内部问答、开发验证 |
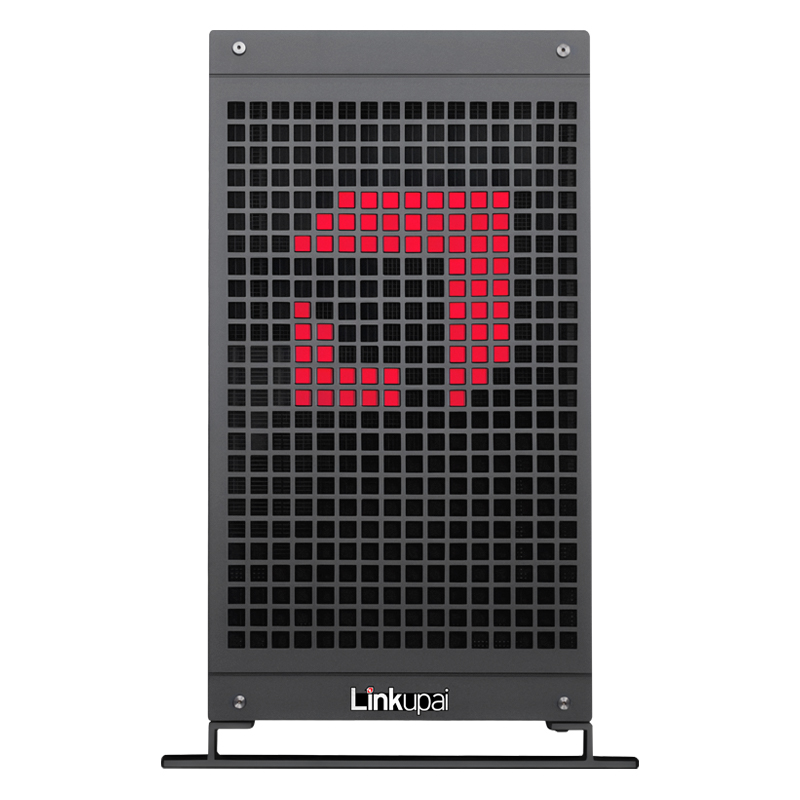
| HI7258 塔式工作站 | Atlas 300I Duo 96G × 4 | 384GB | TP=4,可开 128k / 256k | 全公司文档问答、长文档审阅、多路并发推理 |
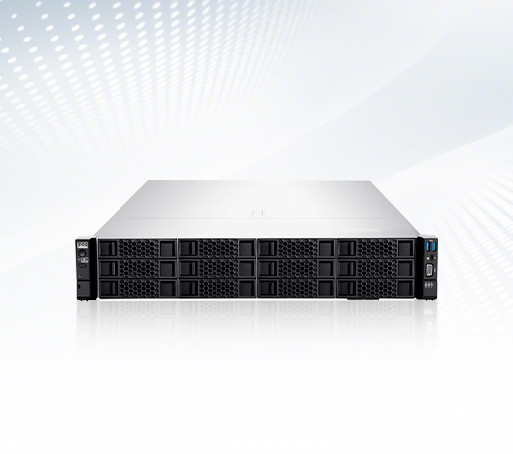
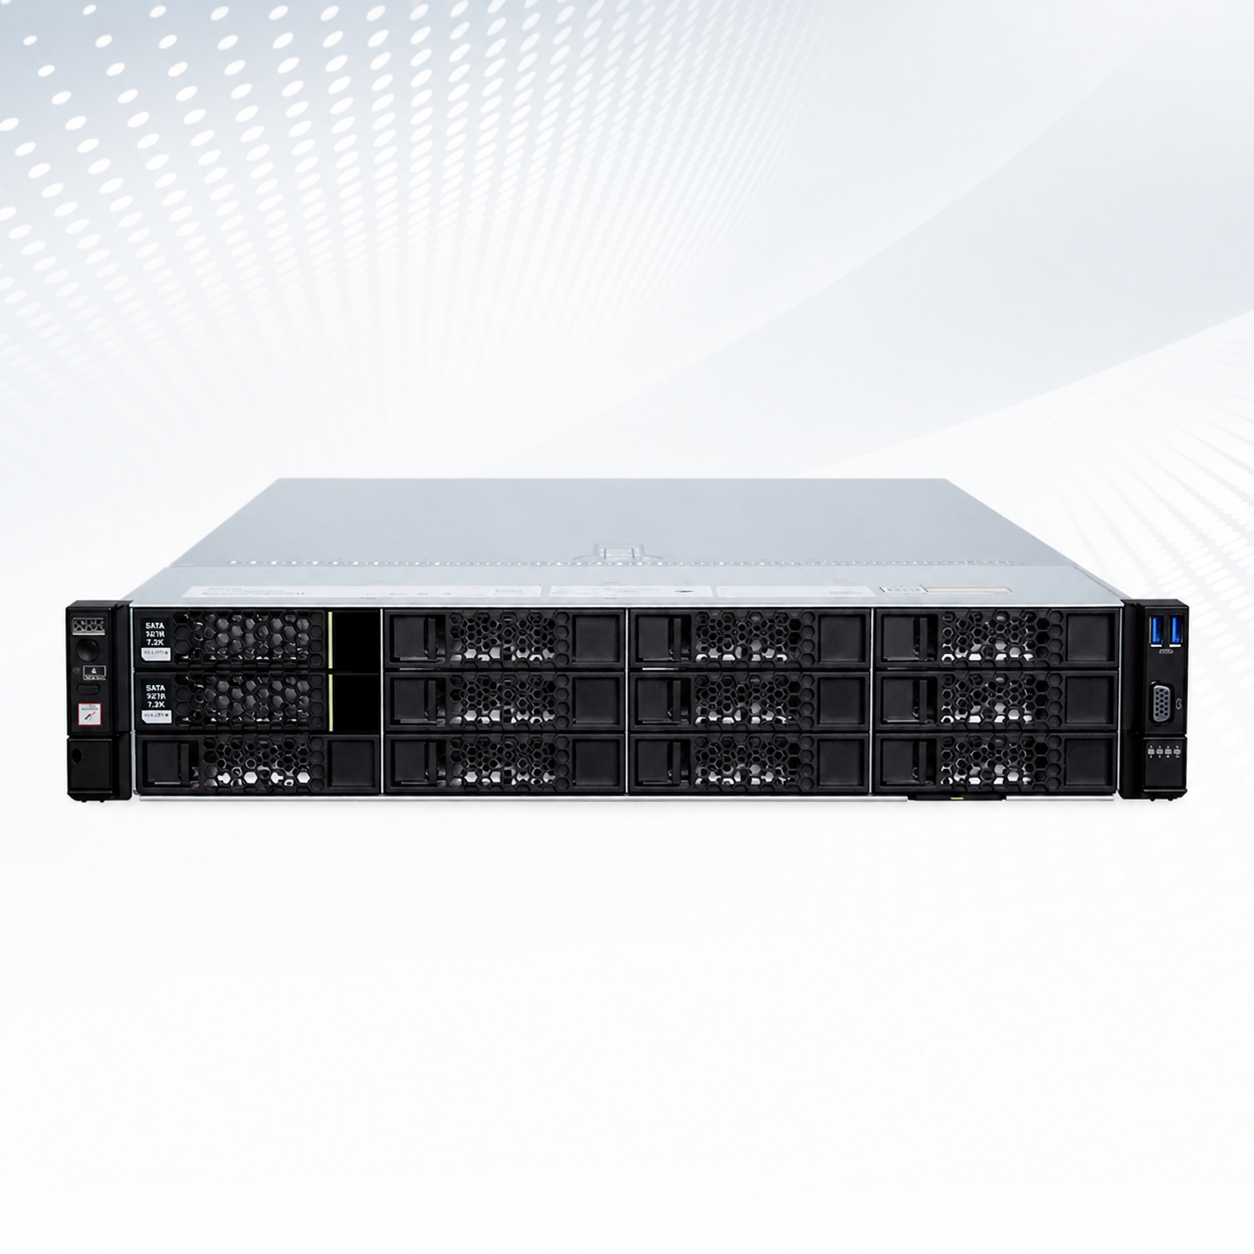
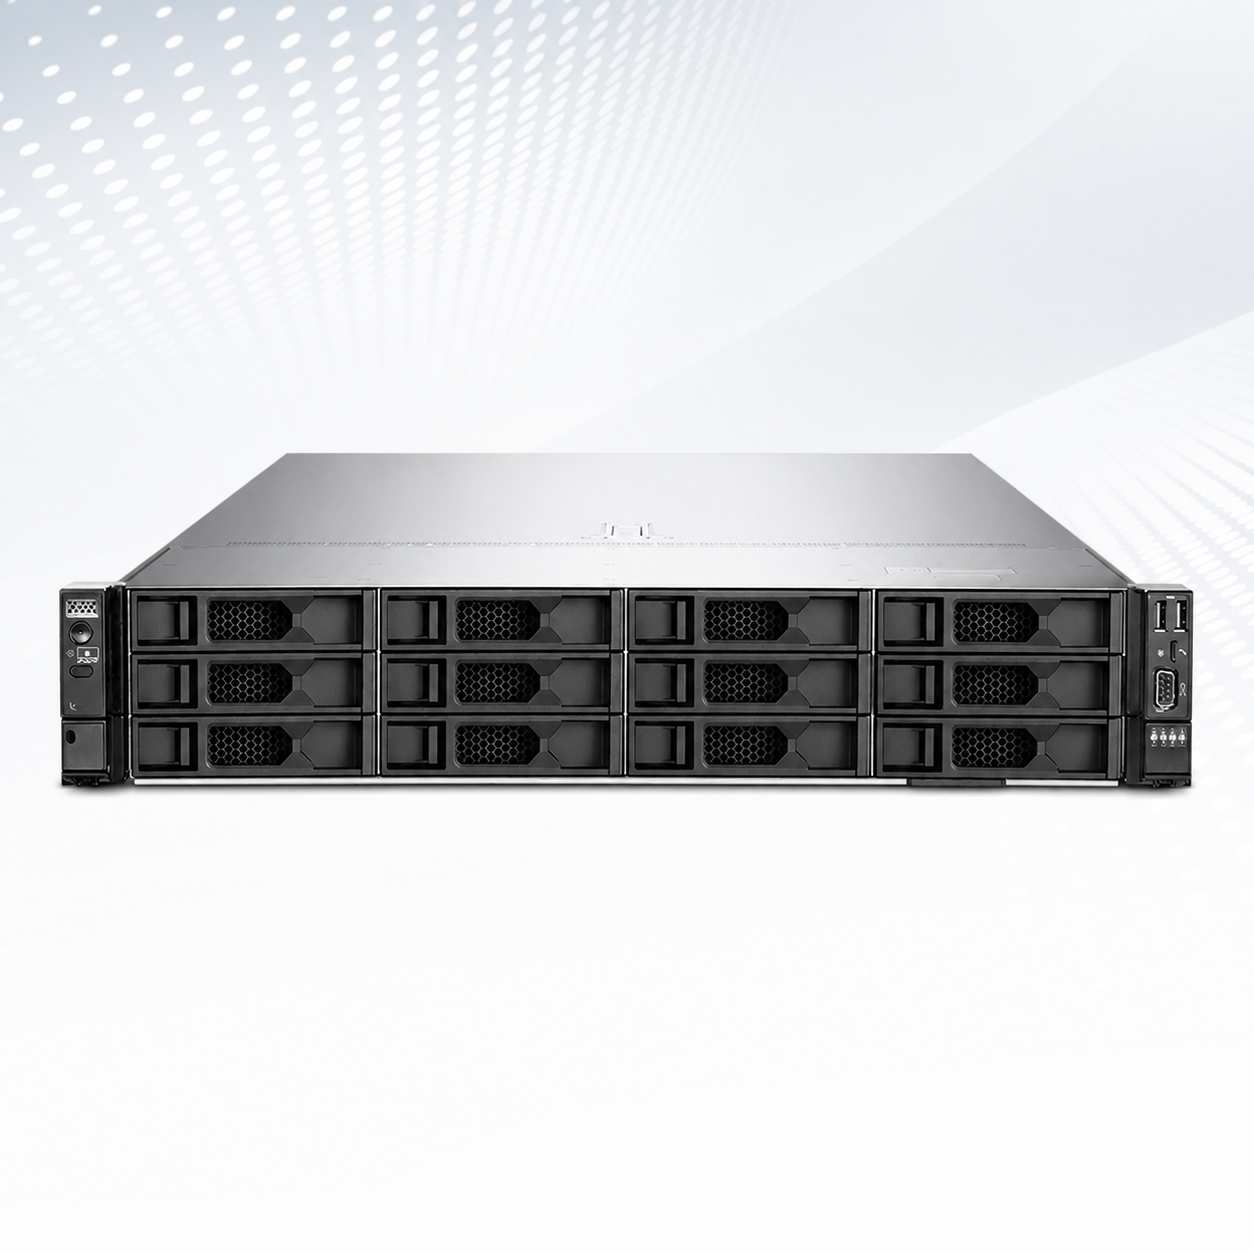
| HG9680 机架式服务器 | 昇腾 910 × 8 | 256GB / 512GB 两种 | 多节点集群 | 训练与推理混合负载 |
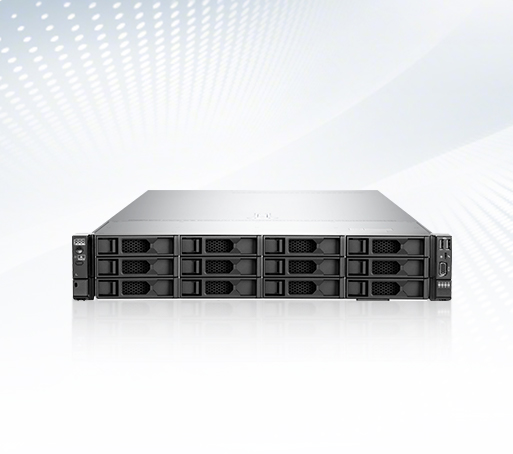
| HG9680 G3 超节点 | 昇腾 910 NPU 模组 × 8 | 1024GB | 超节点组网 | 大规模并发、横向扩展 |
HI5228 和 HI7258 都是塔式形态,鲲鹏 920S 平台,电源 1250W 金牌,HI7258 的 GPU 侧走液冷散热设计。放在办公室或机房角落就能用,不需要专门为它改配电。
判断方法可以简化成三句话:
如果你只是要让团队先用起来——单机内部问答、几个人同时问、答案长度可控,双卡的 HI5228 对应官方 TP=2 档位,是门槛最低的起点。
如果你要让它读长文档——合同、标书、图纸、整本技术手册,上下文要上到 128k 甚至 256k,那就必须走到 TP=4,也就是 HI7258 这个四卡档。这不是性能偏好,是官方给出的能力边界。
如果你要挡几十上百路并发——单机的 KV Cache 池会被并发数切分,每一路能分到的上下文随之缩水。这时候要么按并发增卡,要么用 HG9680 这类 8 卡机型横向扩,同时把请求调度和缓存策略一起设计进去。
关于并发,有一个独立的生产环境数据值得参照:一家云厂商公开的自有用量是 300 多人使用、190 人活跃,每周约 20 万次请求、超过 100 亿 token,网关侧高峰并发 23,prefix cache 命中率 85%,人均输入 84K token、输出 0.5K token。这组数字说明两件事:真实企业负载的高峰并发往往是个位数到两位数,不是几百;prefix cache 命中率直接决定卡够不够用——命中率上去了,同样的卡能扛的并发会成倍增加。
三个会在上线之后才暴露的坑
第一个坑:上下文和并发不可兼得。 官方文档反复提示 --max-num-seqs 设太高可能 OOM,--gpu-memory-utilization 设太高也会 OOM。原理不复杂:KV Cache 的总池子是固定的,每一路并发都要从中切走一块,上下文越长切得越多。厂商和第三方实测在这一点上结论完全一致。所以"我要 256k 上下文,还要同时服务 50 个人"这种需求,必须先在纸面上算一遍显存,而不是买回来再试。
第二个坑:厂商公布的峰值吞吐不能拿来算容量。 有一份厂商压测报告给出单卡短对话峰值 700~857 tok/s,机型是 72GB 显存的 RTX Pro 5000 Blackwell。数字本身没造假,但报告正文没有披露该峰值对应的并发档位、量化方案和引擎版本。同期独立第三方在 24GB 显卡上测出的单卡数字落在 43~64 tok/s 区间——硬件不同,不能直接相减说谁虚标,但足以说明:脱离输入长度、并发数、量化、引擎版本这四个条件,吞吐数字基本没有信息量。 容量规划要问的是"我这个业务形态下的并发与上下文组合能跑多少",不是"峰值多少"。
同类的口径陷阱还有两个真实例子:同一台 DGX Spark,长上下文输入时 23 tok/s、短 prompt 时 50~65 tok/s,差两三倍只因为输入长度不同;vLLM 从 0.26 升到 0.27.2 nightly,同一模型同一量化的 MTP 性能差了将近一倍(7.18 → 17.80 tok/s)。软件版本也要一起锁进验收条件。
第三个坑:Agent 类应用的 token 账单会失控。 有媒体用同一套 9 个智能体任务做了对照实测:Qwen3.8-27B 消耗 13,995,350 token、197 次请求、22,564 秒;对照组另一个模型只用了 956,630 token、87 次请求、1,343 秒——token 相差 14.6 倍,耗时相差 16.8 倍。原因不是模型不行,是它把任务拆成了 75 个步骤而对照组只有 8 个,上下文被反复回灌。如果你的场景是长周期智能体,显存规划之外还得单独规划 token 预算。
顺带一个正面的数字:昇腾官方文档里唯一一条实测性能数据是,在单张 Ascend950PR 上开启 CPU 绑定后,单流 decode 从 32 tok/s 提升到 63 tok/s。一个配置项带来接近一倍的变化,这说明昇腾这条路线上"参数调对"比"多买一张卡"往往更划算。
采购前该确认的七件事
权重版本先定死。 BF16、W8A8、W8A8-MXFP8、W8A8-310P 对应完全不同的硬件门槛,先用哪一档决定了卡数下限。
目标上下文长度写进需求。 128k 和 256k 在 300I DUO 上是 TP=4 才成立的能力,别等到部署时才发现卡数不够。
并发按业务形态估,不按峰值估。 短对话、文档问答、长文档总结、通用复杂任务、智能体编程这几类负载的资源曲线完全不同,必须分类压测,不能用一张总表代替。
确认量化精度可复核。 要求交付方给出同环境下的精度评测结果,注意测试框架要和基准一致,跨框架的数字不能直接比。
软件栈版本必须锁定。 vLLM-Ascend、CANN、驱动固件三者版本不匹配会直接报算子错误或 OOM,这一条官方文档在别的模型教程里专门强调过。
明确数据边界与合规要求。 本地部署的核心价值是数据不出域,但要落实到具体条款:模型权重落盘在哪、推理日志留存多久、运维通道怎么走。数聚红芯持有华为昇腾 APN 合作伙伴资质,这条资质在其官网荣誉资质页有明确列示。
把服务响应写进合同。 大模型上线后的问题大多不在硬件,而在参数、版本和负载形态,需要有人能在现场定位。
常见问题
Qwen3.8-27B 和 DeepSeek 这类模型比,部署门槛是高还是低?
参数量不同,不构成同一维度的比较。Qwen3.8-27B 是 27B 稠密模型,权重文件 51.77 GiB(BF16),走昇腾 310P 量化后可以单机部署;而 671B 级别的模型在昇腾上通常需要多机多卡,例如有公开实践用两台 Atlas 800I A2、每台 8×64GB,W8A8 量化后仍需约 670GB 显存。两者的机房、配电和运维要求不在一个量级。
为什么同一张卡,别人说能跑 256k,我的却 OOM?
三个变量会同时影响结果:上下文是"配置"还是"填满"、并发开多少、KV Cache 的量化精度。理论上分配 256k 的窗口很便宜,但真正把 256k token 填进去时显存才涨到位。第三方在 24GB 卡上复现过这个边界:262,144 直接 OOM,163,840 能启动并跑完,中间差值约 1 GiB。所以别人"能跑"和你"能跑"之间的差异,通常不是卡的问题,是负载形态的问题。
昇腾这条路线的生态成熟度够了吗?
从能落地的证据看:vLLM-Ascend 0.23.0 已为 Qwen3.8-27B 提供了完整的模型教程,包括四套硬件的启动命令、精度评测、性能调优和 FAQ;官方还针对 GDN 融合算子、W8A8 量化、MTP 投机解码、ACLGraph 图模式做了专门优化。同时要如实说明一个边界:官方文档自己标注"性能调优结果尚未充分验证",长上下文、低时延、高吞吐三类典型场景的推荐配置还在补充中。这意味着现在上昇腾跑 Qwen3.8-27B 是可行的,但性能调优需要和交付方一起做实测,不能指望照抄一份参数就达到最优。
想确认 Qwen3.8-27B 在昇腾上该配几张卡、开多长上下文,可以直接把场景发给我们,按你的实际并发和文档长度算一遍显存再给配置。全国统一服务热线:400-869-9865,也可以在线留言说明你的业务场景。
相关配置可直接查阅:HI5228 昇腾 AI 一体机、HI7258 塔式工作站、HG9680 机架式服务器、HG9680 G3 超节点;昇腾 910B 信创算力落地案例与AI 训练和推理解决方案可作为选型参考。