




需求在涨,算力见顶
企业 AI 算力需求年增 53%,预算还没批下来,算力先见顶。扩不动,也停不下。
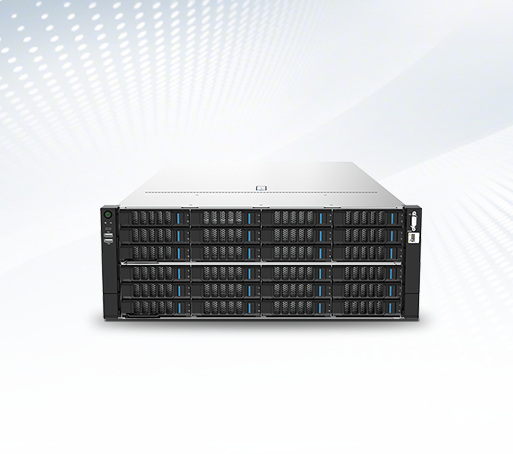
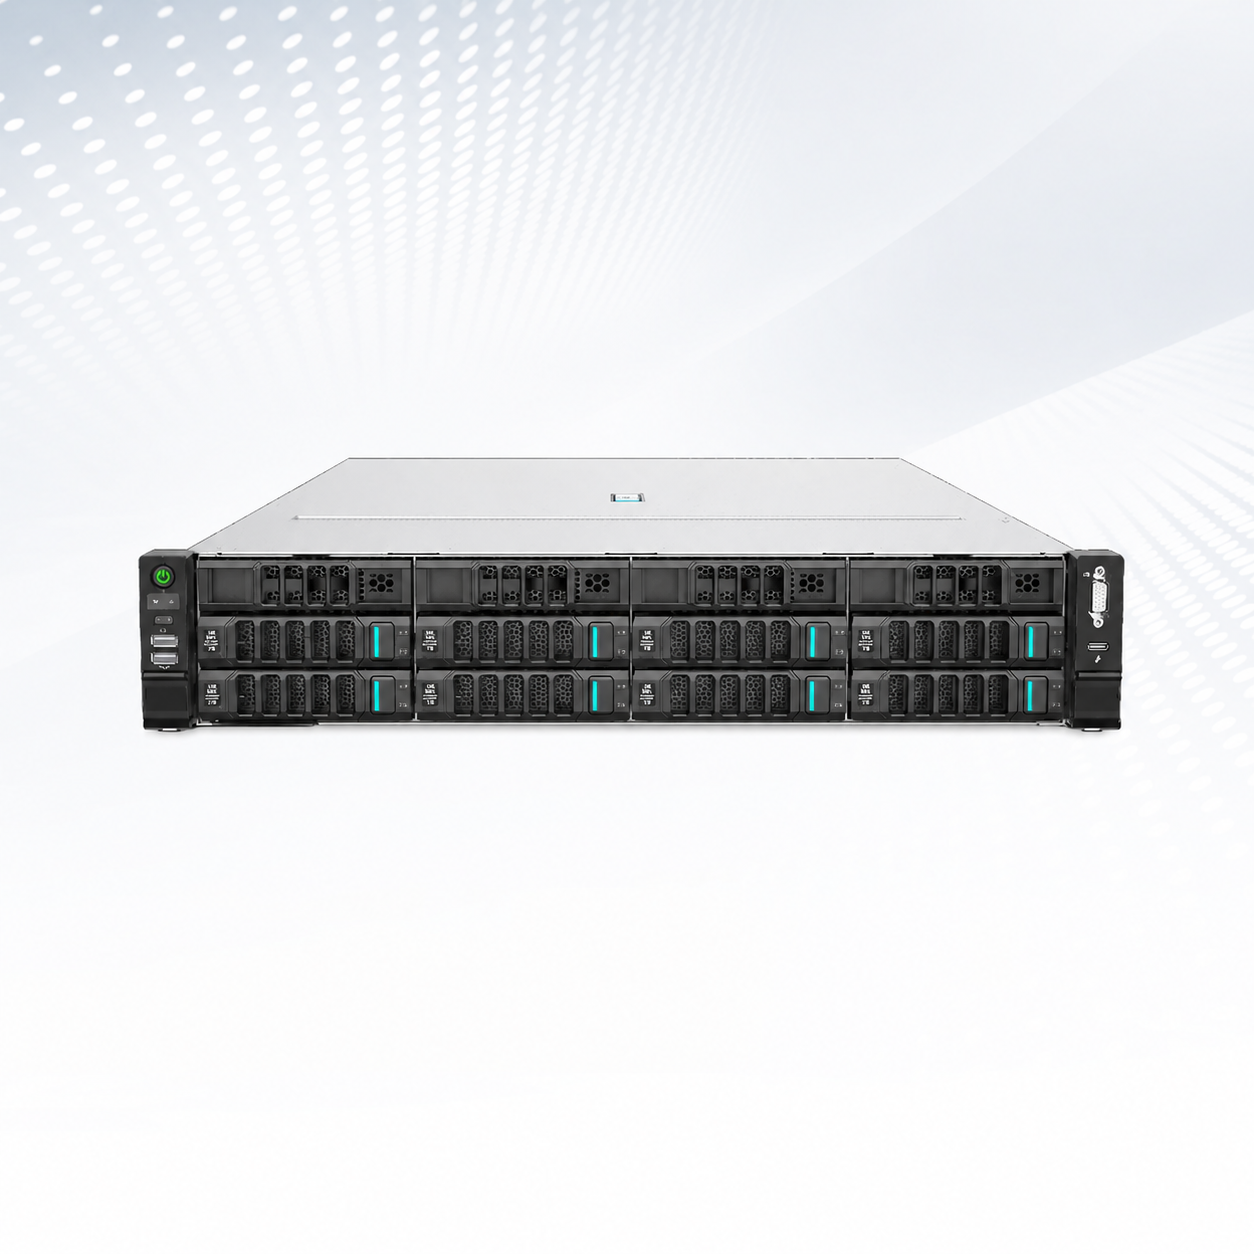
解决不同计算场景,不同数据形态的设计模拟问题

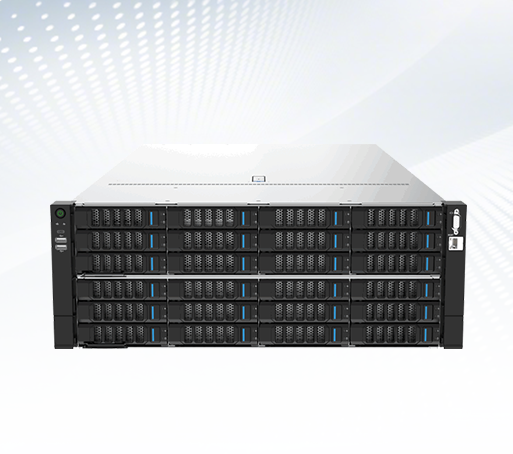
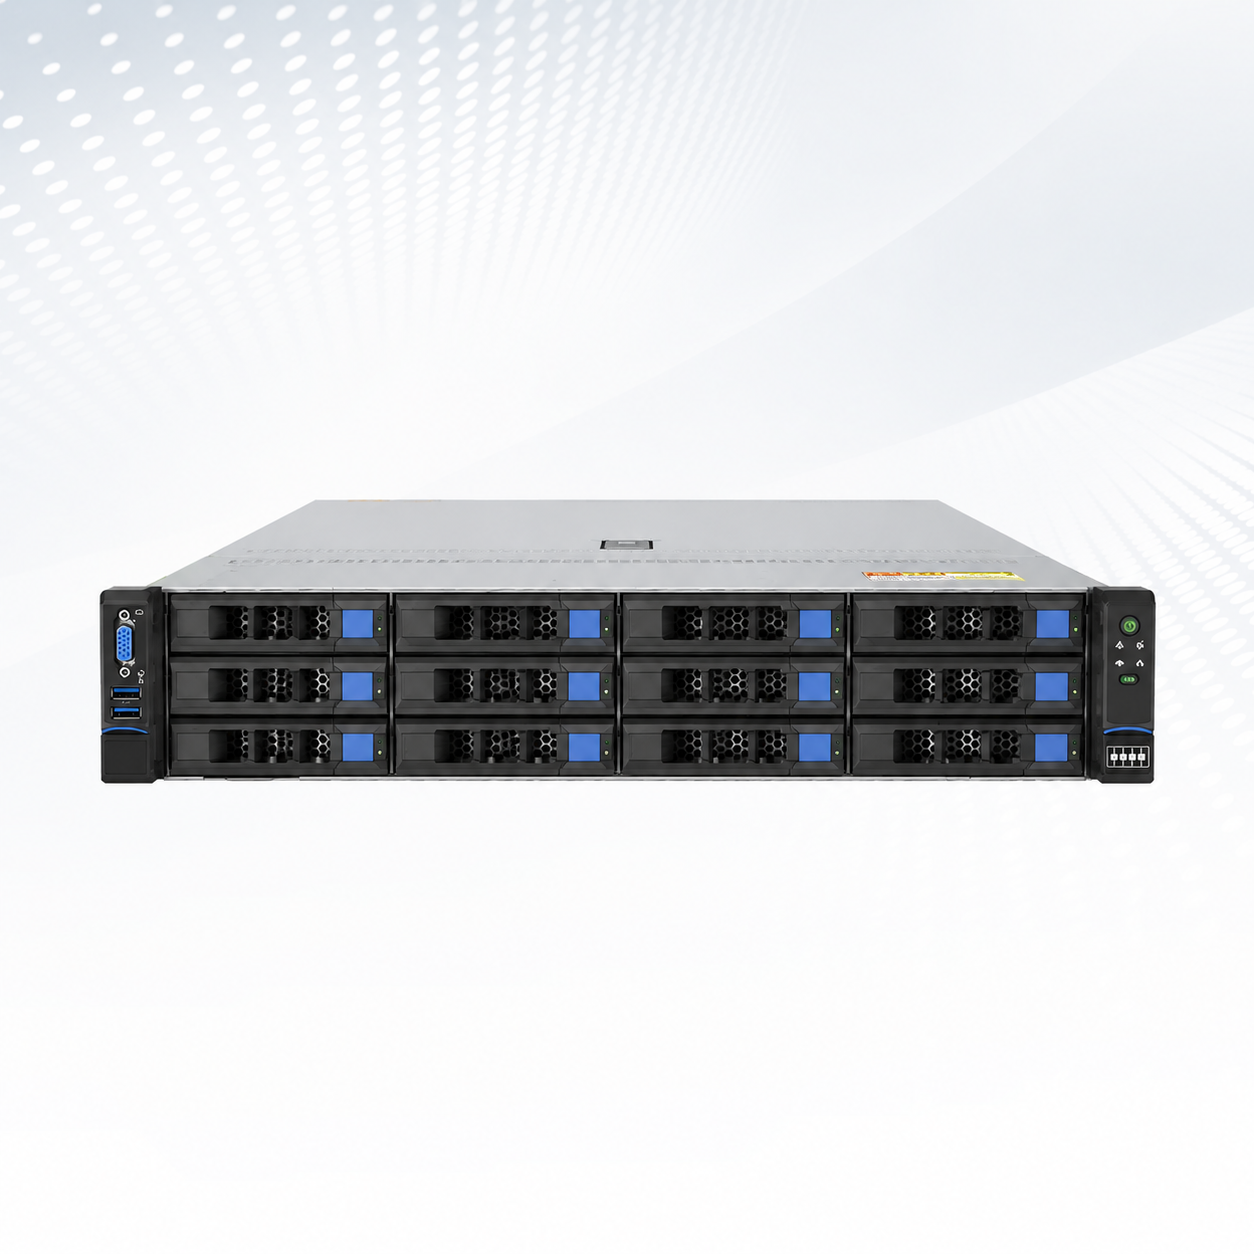
解决不同计算场景,不同数据形态的设计模拟问题
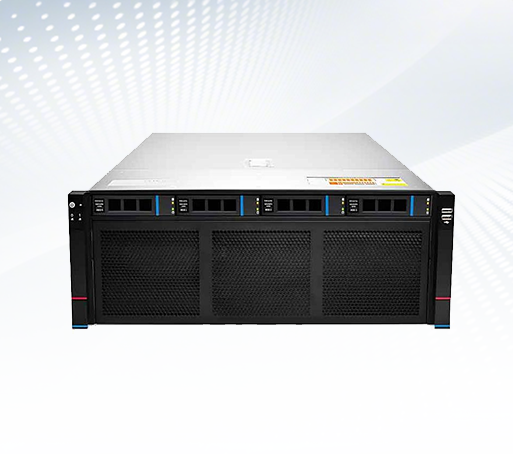
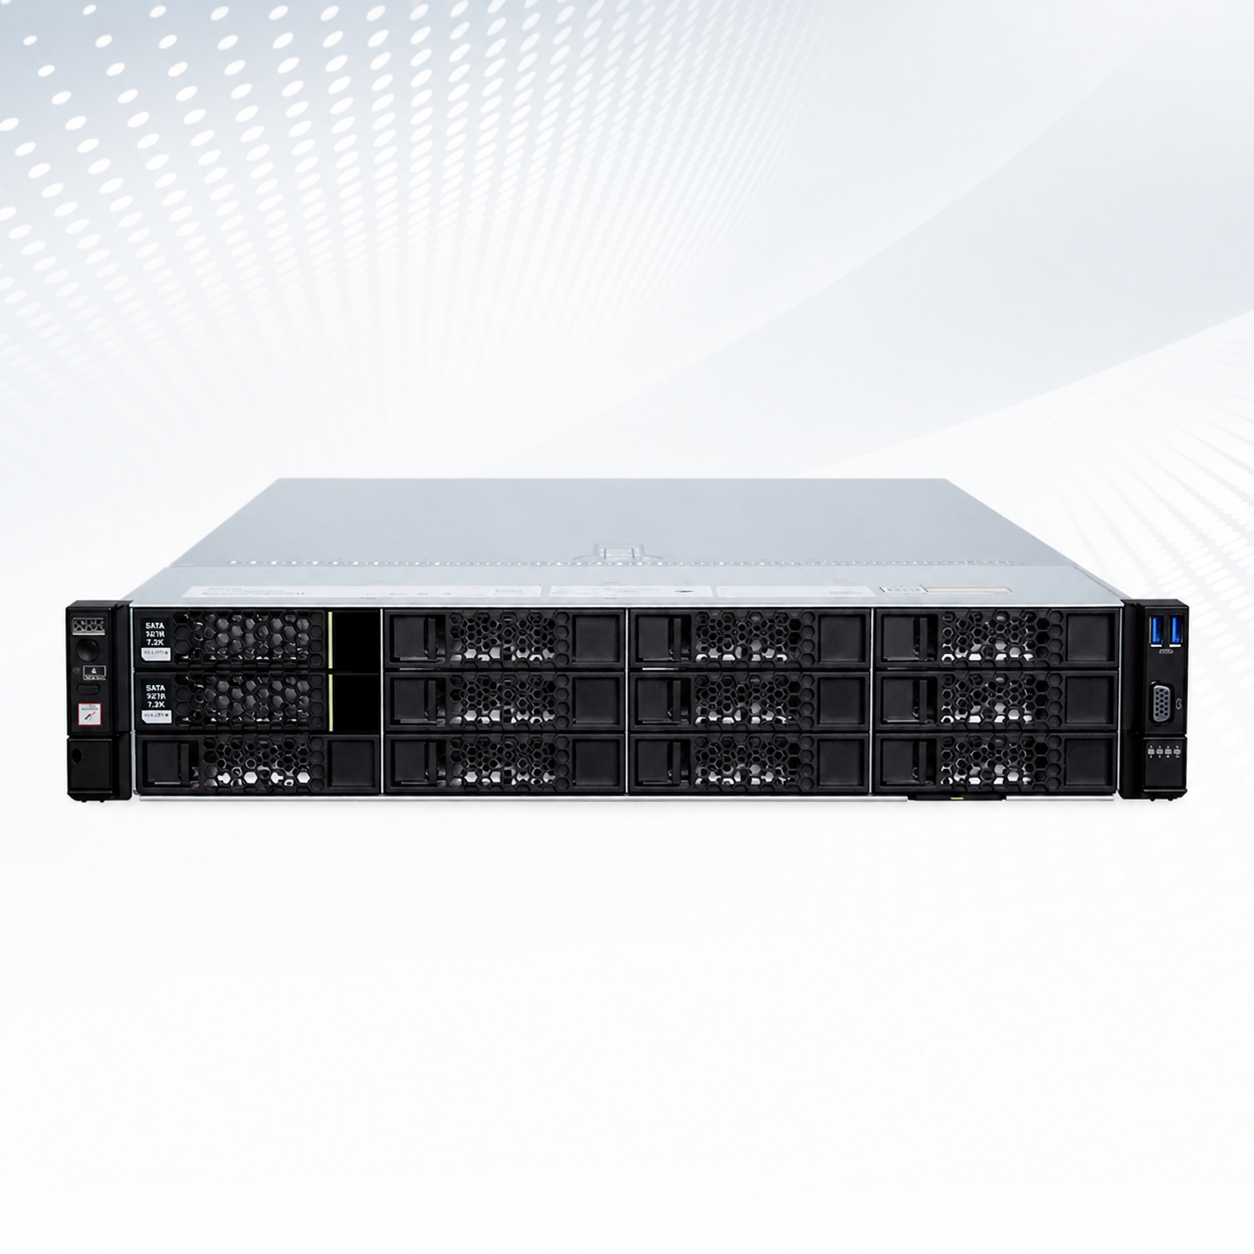
解决不同计算场景,不同数据形态的设计模拟问题
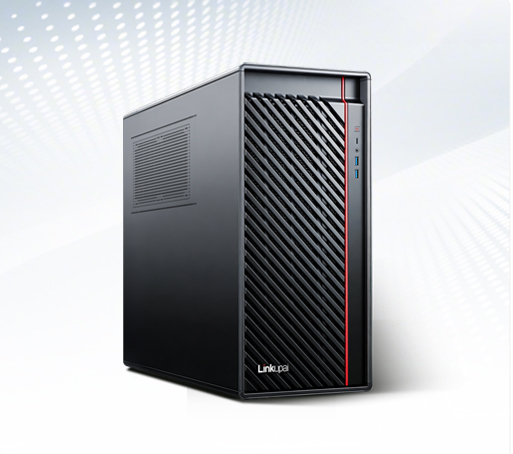
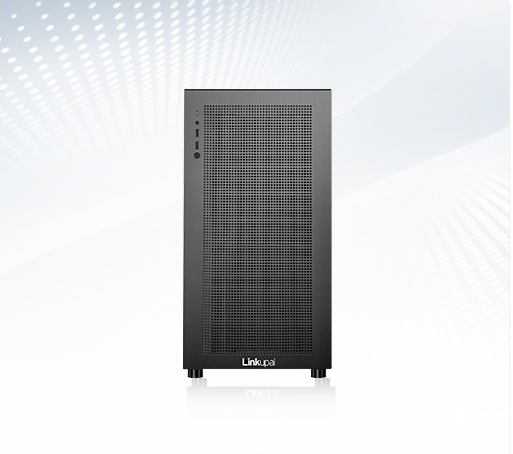
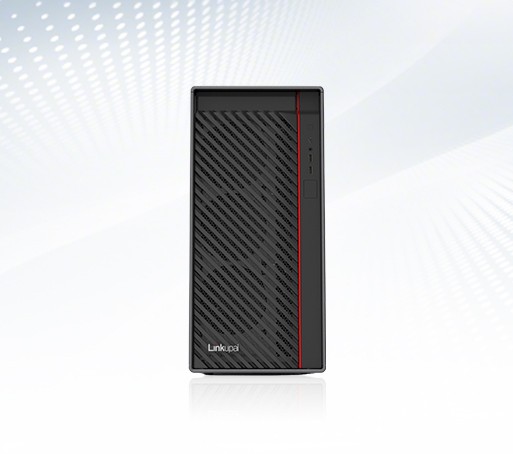
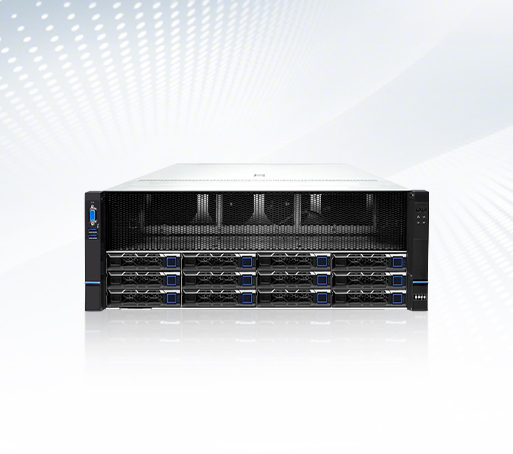
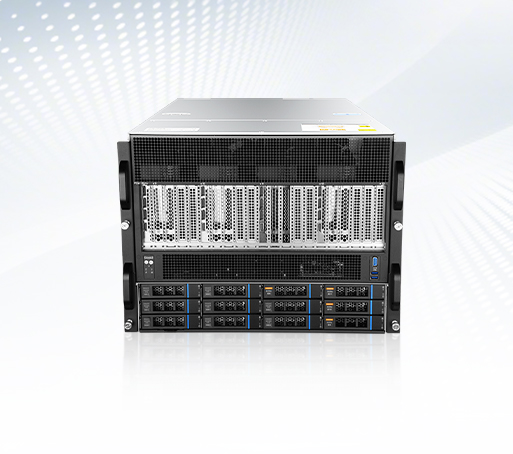
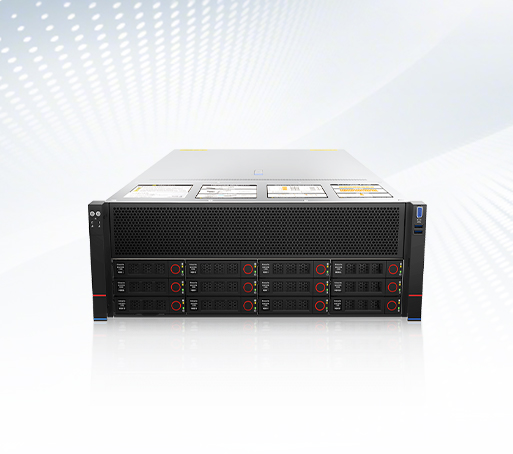
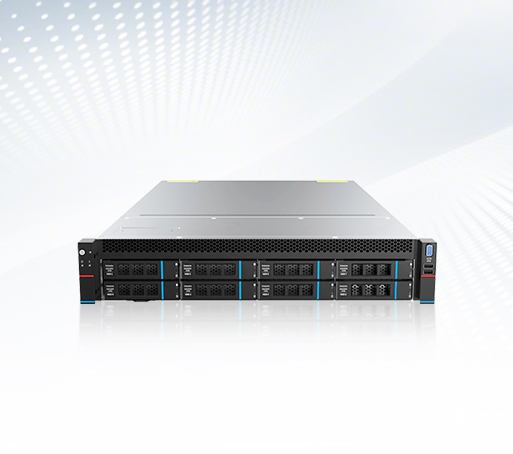
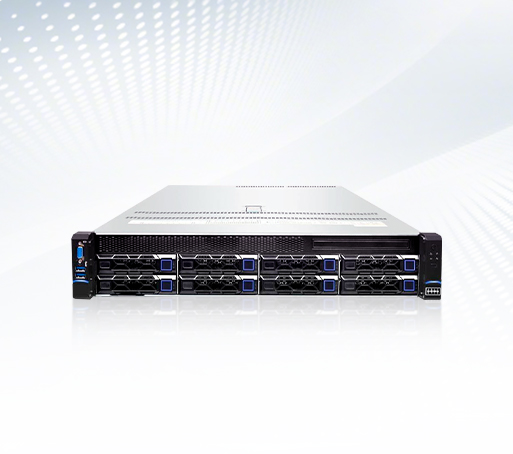
数聚红芯 Token 工厂以「远程算力 + 本地算力」组合交付,提供基础算力、高效平台与服务支持,屏蔽底层算力差异;从实际应用场景出发,直接交付可用的 Token 服务,支持各类应用与不同参数量模型。
企业 AI 算力需求年增 53%,预算还没批下来,算力先见顶。扩不动,也停不下。
按 Token 计费,账单随用量线性上涨,成本摊不到部门和项目头上,预算没法提前做。
国产 GPU 厂商多,各家软件栈、算子库和工具链都不同,选谁,都怕被锁死。
模型换个版本就要重新适配、重新量化、重新调优,没有专人长期跟进。
核心业务数据不能出企业,走云端 AI 服务存在泄露风险,法务和合规这一关过不去。
业务高峰时并发翻几倍,首 Token 延迟抖动明显,体验和口碑一起掉。
从立项、采购到部署上线,要过多道关,投入大、周期长、风险还不低。
上线只是开始,模型要更新、用量要调优、故障要有人接,没团队跟进就会荒废。
点击箭头或左右拖动时间轴,查看全部痛点
按真实模型与并发实测配置,资源利用率较传统模式提升 75%+,不为峰值过量备货。
先用 Token 资源包跑通业务,验证效果后再按实用量扩容,分阶段控制投入。
用量报表按部门、项目、模型拆开,成本分摊与运营分析形成闭环,续期预算有据可依。
高可用架构保障 99.99% 可用性,监控、权限、扩容、模型更新均有明确归属。
核心数据必须留在本地,高峰算力又不想一次性投入;
本地跑敏感推理,弹性走远程。
适用:大型集团科技子公司、传统企业智能化部门;
要求数据不能出企业,AI 长期规划。
算力可租可采,平台与服务一次交付。
提供现有 Token 平台资源,按需求与预算
订阅式交付,TaaS(Token as a service)。
低成本快速接入,无需技术投入,按需使用。
| 看这几件事 | 纯远程算力 | 纯本地算力 | 远程 + 本地组合 |
|---|---|---|---|
| 初始投入 | 按量付费,无硬件投入 | 硬件采购,一次性投入大 | 本地按需配,弹性走远程 |
| 上线速度 | 最快,当天开通 | 慢,含采购与部署 | 较快,先远程验证 |
| 数据边界 | 数据需出企业 | 数据全部留在本地 | 核心数据本地,弹性任务走远程 |
| 模型控制 | 受平台限制,换模型不自由 | 完全自主 | 自主,本地与远程分工 |
| 运维压力 | 由平台承担 | 需要专人 | 由平台与服务分担 |
| 适合场景 | 临时验证、非敏感业务 | 高合规、长期稳定负载 | 负载波动大、数据敏感 |
| 主要限制 | 成本和边界可控性有限 | 前期投入大、周期长 | 需先明确数据流向与调度规则 |
先问清楚要解决的业务问题、用哪个模型、多少并发、数据能不能出本地。
把三条路按你的情况各算一遍,摊开讲清楚哪条便宜、哪条快、哪条以后改代价小。
用你真实的模型和数据压测,实测加载时间、首 Token 延迟、P95 和稳定性,不看标称。
算力、平台、API、权限、监控开通到位,交付管理员账号、使用文档,当场跑通验收。
按用量和成本出报表,跟进模型更新、按需扩容,按业务指标做阶段验收。

这十个问题直接决定算力配得准不准,建议转交采购与技术评审逐条核对。
推理、微调、训练对显存与卡间互联的要求完全不同,配比定了才能定卡型卡量。
参数量决定显存下限,量化方式决定精度损失,版本决定要不要重新适配。
上下文长度直接吃显存,是配置留裕量常见的原因;应要求供应商给出具体 token 上限与实测显存占用。
平均值没有意义,要让对方给出 P95 延迟和业务高峰时段的表现。
这一条决定哪些算力必须本地、哪些能走远程,是所有选型的前置条件。
两者性能与生态差异明显;信创评审决定可选机型,生态决定后续适配成本。
大模型加载,瓶颈通常不在算力而在存储带宽,这一项最容易被忽略。
这一条同时决定要不要自建机房,以及数据在两端之间怎么分流。
没有明确责任人,建完就是机房里的闲置资产。
要把算力、软件、运维、扩容一起算进来,只比硬件单价没有意义。
「要花多少钱」「会不会白买」,这两个问题我们直接给结论。
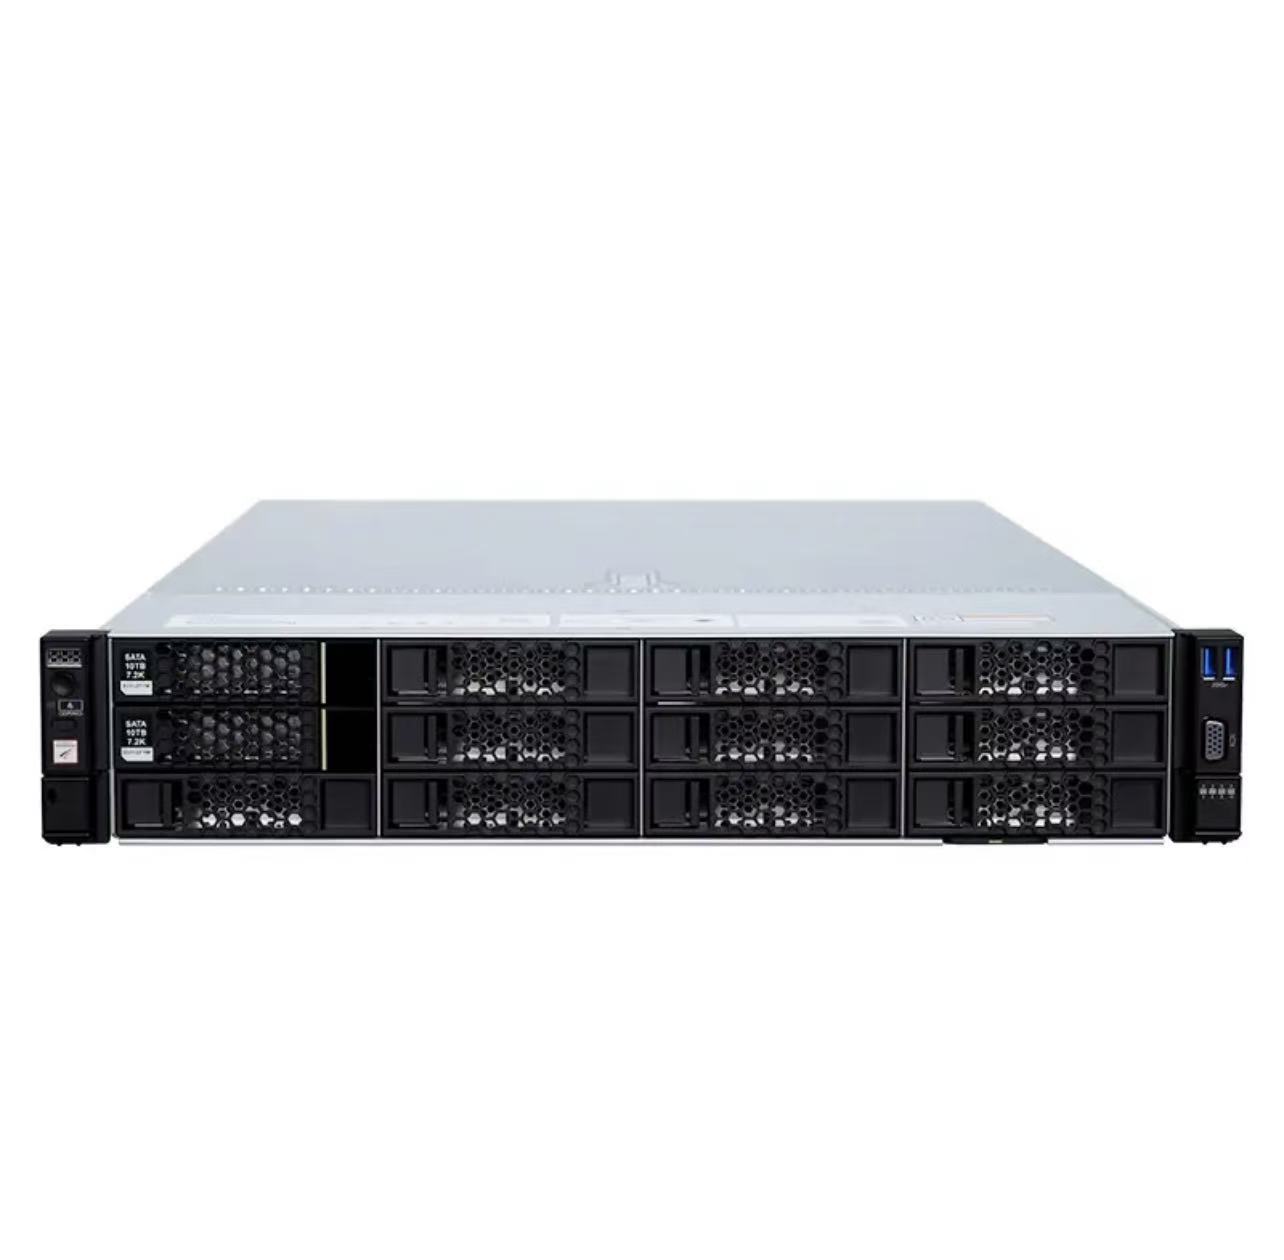
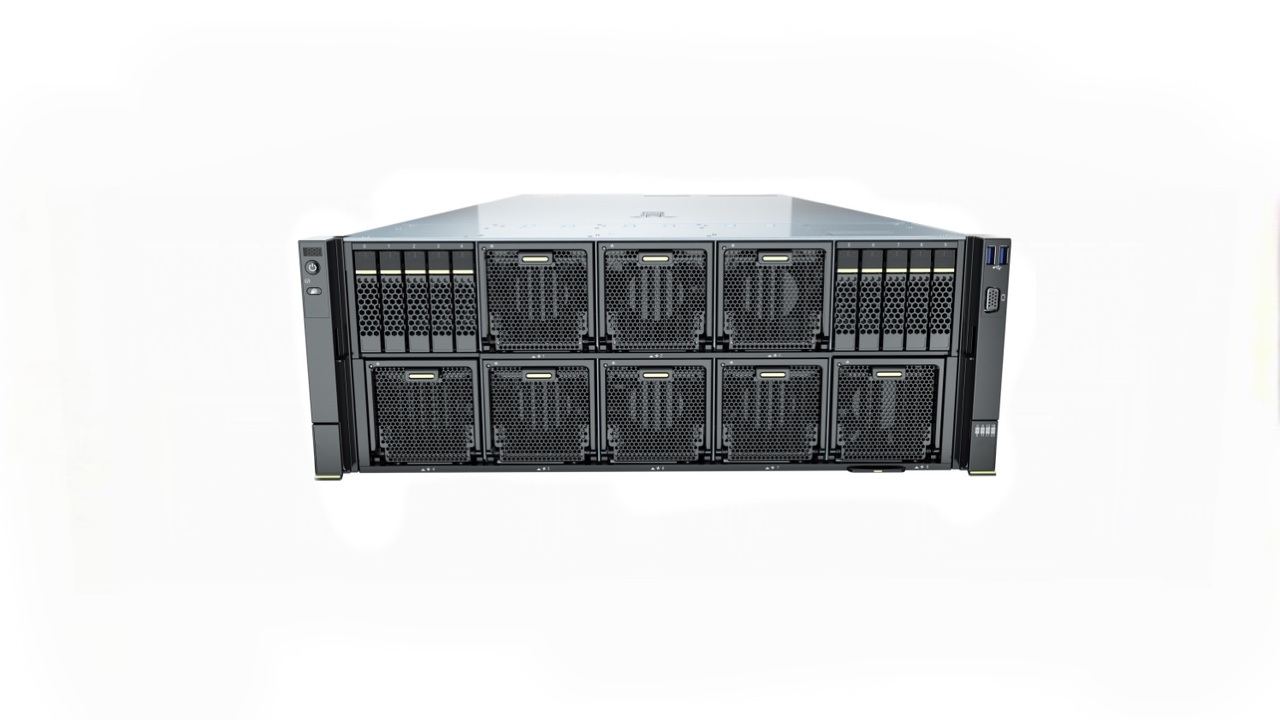
GPU 服务器只给算力;Token 工厂在其上再叠调度、模型服务、统一 API、计量和运维—买硬件和买能用的能力,是两件事。
能。走资源包或混合模式,核心数据留本地,弹性任务走远程,不用自建机房。
看两条:数据能不能出企业、用量稳不稳。都不确定就先租算力验证。
能。平台对外只暴露标准 API,可以自行对接接入自己的知识库。
千问、智谱、kimi、豆包、DeepSeek 均可部署;换模型只改一个模型名称。
支持。昇腾 NPU、国产 GPU、信创服务器均可选,已有华为昇腾 APN 认证。
取决于配置、交付范围和用量。先做场景盘点拿到实测数据再报价。
架构预留扩容位,按需加卡;模型更新由我们跟进,按业务指标验收。
按你的模型类型、并发量和数据边界配置算力,按月租用、按量计费。
训练、推理、优化、部署、运维全生命周期覆盖,用多少扩多少,权限和用量都分得清。
欢迎联系我们,请描述您的需求,我们的团队将在 3 个工作日内与您取得联系。或拨打热线 400-869-9865 立即咨询。


专业的顾问服务
耐心的答疑解惑
全国统一服务热线:400-869-9865
邮箱:business@linkupai.cn
专业的顾问服务
耐心的答疑解惑
全国统一服务热线:400-869-9865
邮箱:business@linkupai.cn